SemiAnalysis日前發佈了一份AMD與NVIDIA顯示卡在Qwen3.5 397B及MiniMax M3兩款開源大模型上的性能及成本對比,出戰的是兩邊當前最強的MI355X顯示卡與B300顯示卡。
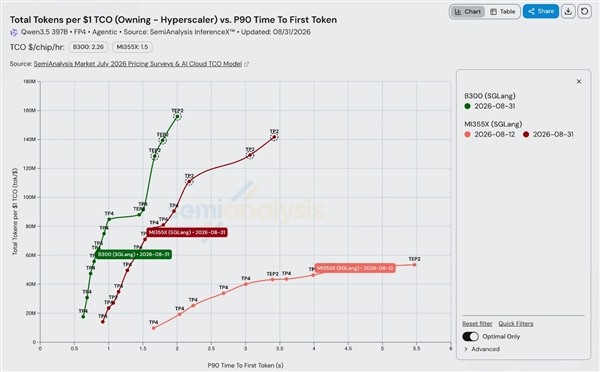
AMD這邊對比了兩個時間點,一個是8月12日,一個是最新的8月31日,因為NVIDIA的顯示卡性能一如既往保持水準,AMD則是在快速最佳化提升。
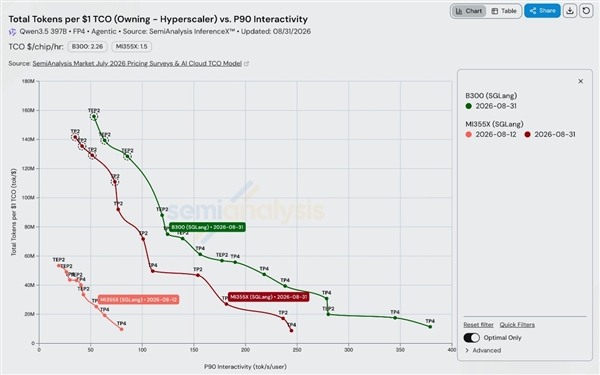
在Qwen3.5大模型上,AMD在短短兩週時間內就大幅提升了MI355X顯示卡的表現,8月12日時90 TTFT(首字時間)大多在2.0秒至5.5秒之間; 8月31日時大部分工況的時延壓縮到了0.9秒至3.5秒區間,響應速度提升近一倍。
此前MI355X的吞吐性價比天花板在50M tok/$左右;最佳化後在低時延段(如1.5s -2.5s)就突破了80M-110M tok/$,並在TP2工況下最高達到了~140M tok/$,差不多三倍水平。
這個性能也非常接近NVIDIA當前的旗艦AI卡B300了,不過後者在低時延下的性能依然領先。
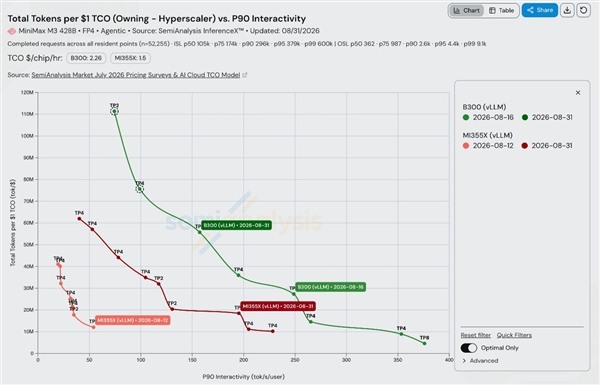
在MiniMax M3大模型上也有類似的結果,8月12日時MI3550X跟B300差距很大,但到了8月31日,最佳化後的MI355X互動速度從之前大約55tok/s/user提升到了230tok/s/user,也是三倍左右的提升。
整體來說,AMD在過去兩週時間內就大幅最佳化了MI355X的性能,兩個開源大模型中各種工況下速度提升2倍到3倍是不成問題的,部分情況下提升超過3倍,儘管還不能說超越B300,但性能水平也是天差地別了。
別忘了,AMD的顯示卡在性價比上依然有優勢的,MI355X的每小時Tco成本是1.5美元,B300是2.26美元,差距在1/3左右,折算下來MI355X的整體效益也很可觀了。
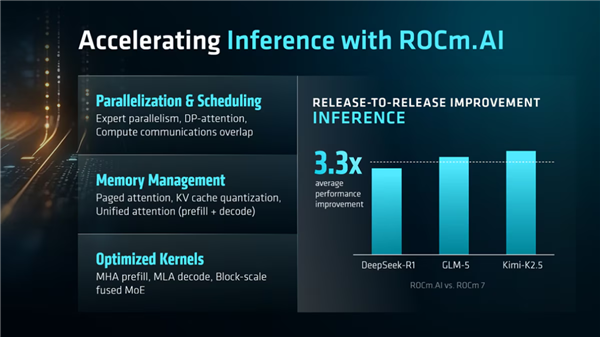
AMD的這些提升基本上符合他們發佈ROCm 10時的宣傳,在硬體不變的情況下各種最佳化就能把大模型的推理性能提升3倍以上。
有了這些基礎,AMD真的可以不用仰視CUDA的生態優勢了,今年還會有性能更強大的MI455X新一代AI平台上市,繼續最佳化的話說不定可以趕超NVIDIA一次。