在這次 Arm CSS for Mobile 2 平台中,對於 AI Agent 相當重要的處理器部分,Arm 也做了相當大幅度的更新,所以在看完整個平台以及 GPU 的介紹之後,接下來我們就來看看這個部分。
先前有關 Arm CSS for Mobile 2 平台的介紹請看:
Arm 推出 CSS for Mobile 2 平台 在 AI 時代提供行動裝置更強顯示效能與 AI 代理運算能力
Arm CSS for Mobile 2 平台解構 GPU 篇:以 AI 原生設計賦予更多顯示效能 在行動裝置上達到 PC 等級體驗
這次負責 CPU 部分介紹的是 Arm 負責 CPU 產品管理以及邊緣運算的主管 Daniel Lu,同樣的因為現場翻拍螢幕效果的關係,以下就用 Arm 提供的簡報來進行介紹。
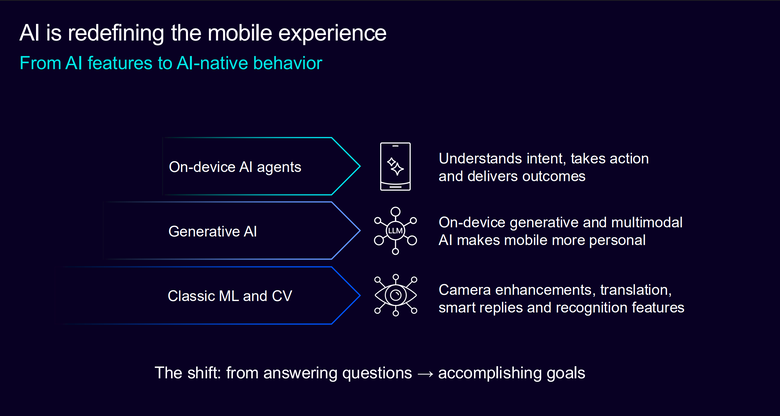
首先一樣是老話重彈(?),Arm 表示 AI 正在重塑整個行動體驗(這句話陳拔最近真的一直聽到),從過去單純的單次執行機器學習、推論運算、到生成內容的生成式 AI、再到裝置端上執行的 AI 代理,從單純的問與答到完整的工作解決方案,短短這一兩年所帶來的更動幅度真的相當巨大。
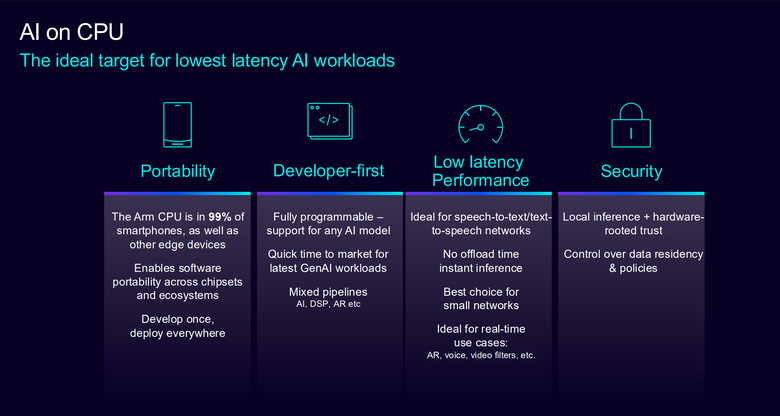
而要在行動裝置 CPU 上面執行 AI,以使用型態上最重要的就是要降低在 AI 工作上的延遲,另外在裝置的可攜性(處理器發熱、功耗)、對開發者的友善程度、 安全性設計等,都是相當重要的層面,而 Arm 過去在行動裝置處理器設計上所累積的經驗,在這個部分正在嶄露優勢。
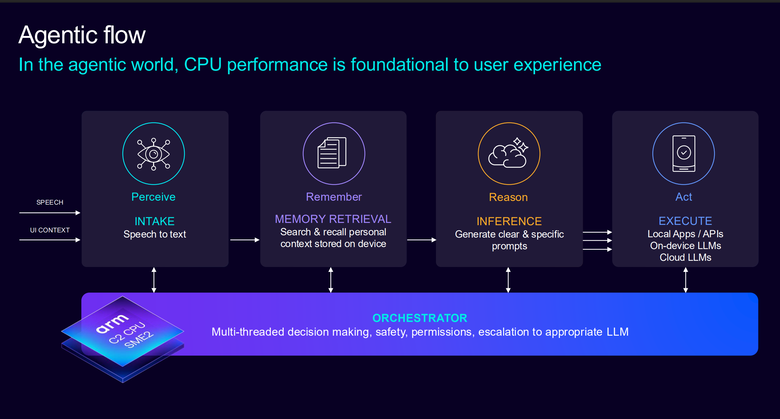
而講到這次的主要目標: AI 代理,Arm 在這部分透過整個 AI 代理的運作流程,從感知、記憶、理解、動作四個循環步驟,來說明這次 Arm CSS for Mobile 2 平台中,具備 SME 2 引擎的 C2 CPU 所扮演的角色,而 Arm 也表示 CPU 的效能正是 AI 代理在行動裝置體驗中的重要基礎。
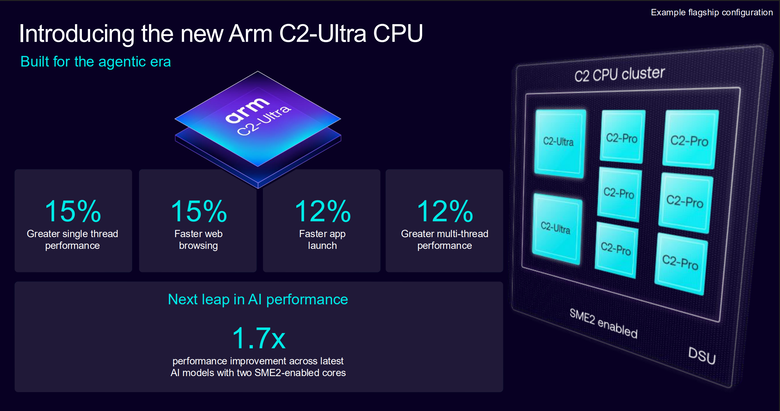
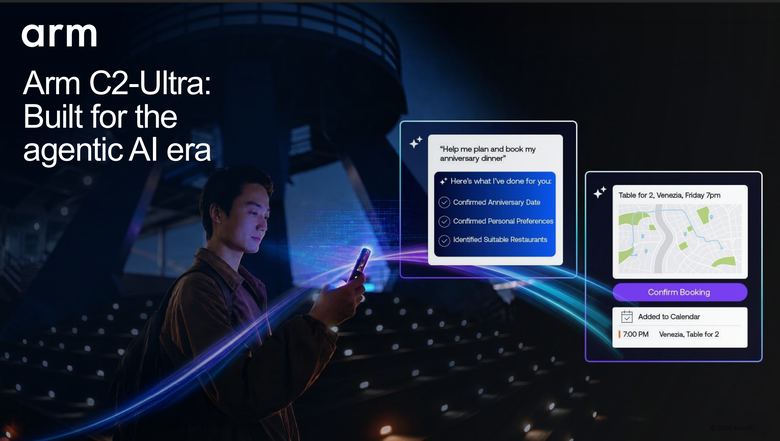
接著就來看這次的主角:Arm C2-Ultra CPU 核心,Arm 表示 C2-Ultra 是專為 AI 代理所設計,跟上一代,在單執行緒效能部分提升 15%、網路瀏覽速度加快 15%,App 啟動速度加快 12%、多執行緒效能提升 12%,而在整體的 AI 效能部分則是有 1.7 倍的提升,Arm 也在簡報中展示了 C2 CPU 叢集的參考配置旗艦版本,由 2 大(C2-Ultra)6 小(C2-Pro)核心組成,並且加入 SME2 引擎以及 DSU 架構設計來共享電源管理以及對外擴充能力。
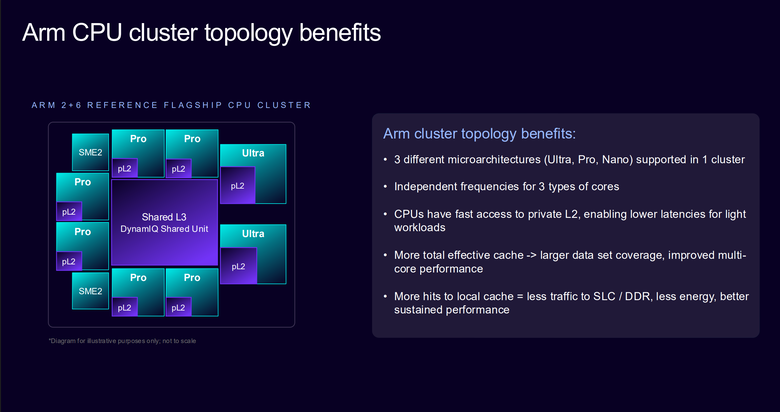
從上圖的架構表示可以看出,在整個 CPU 叢集中,除了每個核心有其獨立的 pL2 快取外,叢集裡每個 CPU 核心以及 SME2 引擎還會直接共享 DSU 架構的大型 L3 快取記憶體,讓資料可以快速地在各個核心以及 SME2 引擎中轉移,來應對 AI 代理依序使用不同模型處理同筆資料時的低延遲需求。
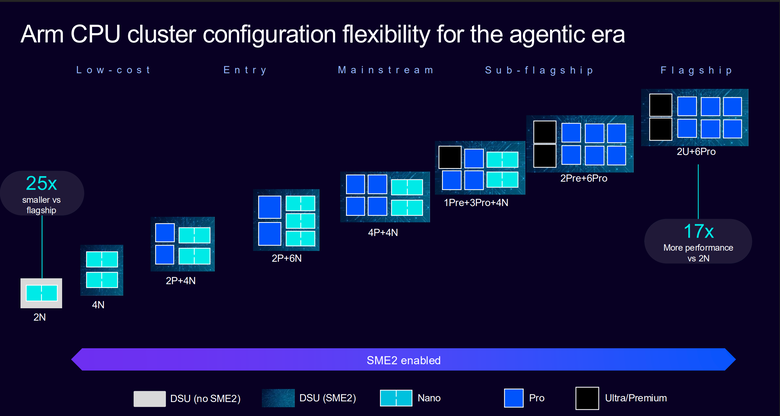
而 Arm 這次在 C2 CPU 核心中也推出了三種不同等級的核心設計(Ultra、Pro 跟 Nano),這三種不同的核心分別以不同的時脈獨立運作,客戶可以依照自己的需求組合在同一個 CPU 叢集內,上圖是 Arm 所展示的不同核心組合所帶來的產品定位與效能表現差異,但不管是哪個組合,均支援 SME2 引擎。
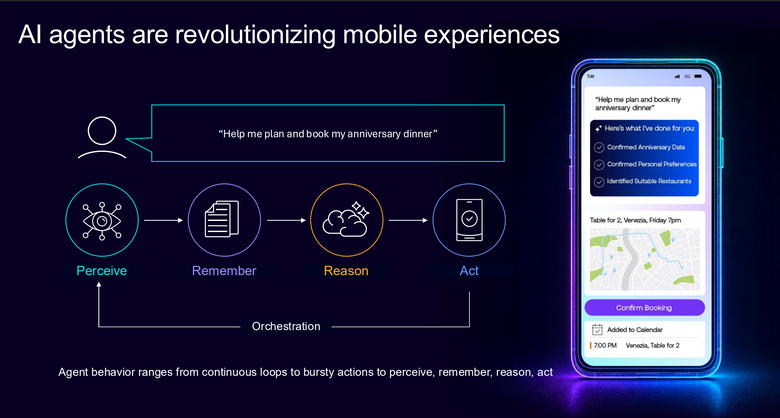
而至於 AI 代理在行動裝置上到底能做甚麼?Arm 在簡報中也做了簡單的示範,過去我們要規劃一個周年的慶祝約會,往往要先確認好時間、找餐廳、進行訂位甚至是預先點菜等,這裡面牽扯到行程的確認、個人喜好的確認、餐廳是否有空位的確認等等,都要使用者一個個分開執行。
而在 AI 代理進入到行動裝置後,使用者只要跟 AI 代理說一句:『幫我計畫一個周年慶晚餐約會並且訂位』,AI 代理就會利用上面所說的感知/記憶/理解/動作等流程,利用不同的模型進行協作,先搜尋手機內的行事曆確認周年慶的日期、透過照片搜尋成員喜歡的菜式風格、搜尋活動範圍內是否有合適菜式、評價良好的餐廳,自動進行訂位查詢,最後直接跟使用者說:『我幫你找好了這個時間點這家餐廳有空位,要訂位嗎?』,確認定位之後還會自動設定行事曆提醒。(會不會太懶了一點)
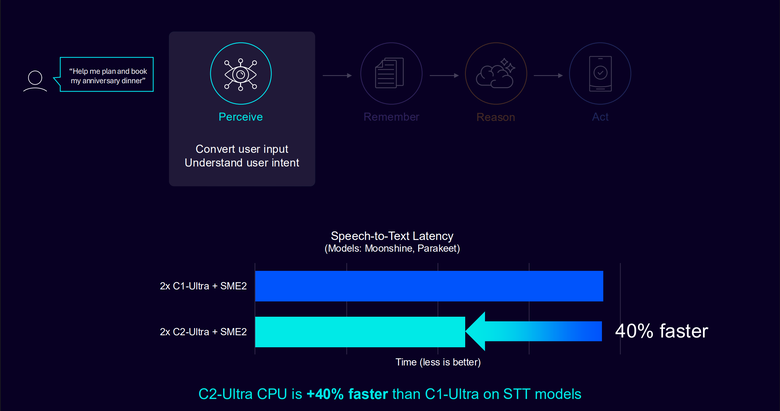
而 C2 CPU 叢集在這邊扮演的角色以及效能提升的幅度,可以從各個步驟來看,首先在感知部分,會先將使用者輸入的內容(不管是語音或是文字)進行轉換,C2-Ultra 在這邊會執行語音轉文字的模型,以雙大核的配置來說,比起上一代 C1-Ultra 要快了將近 40%。
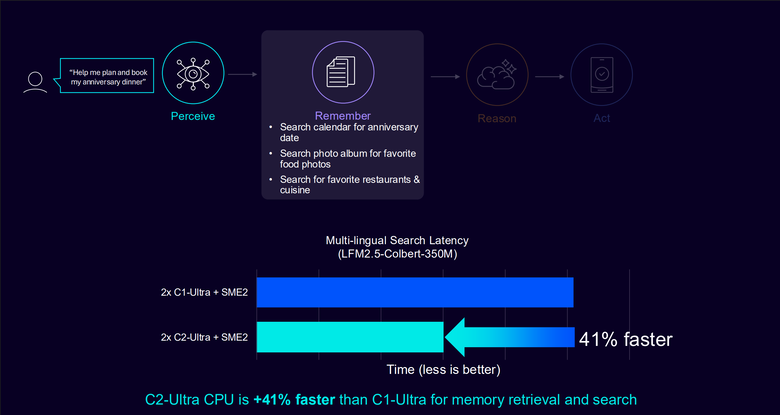
而進入到記憶步驟,會搜尋行事曆內周年慶的日期,在相簿內搜尋喜歡的菜式照片以及喜歡的餐廳或是美食種類,在這類多重語言模型的執行部分,C2-Ultra 搭配 SME2 引擎的效能比起上一代要快了 41%,所需要的時間更短。
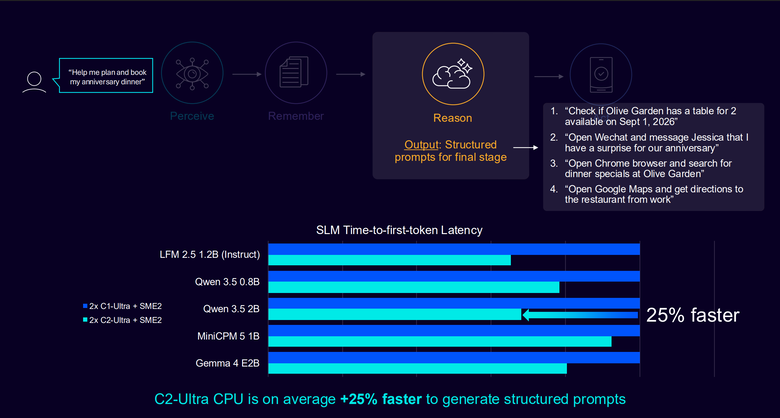
到了理解階段,則是針對最後的動作進行結構化提示詞的產出,像是確認周年慶當天餐廳是否有空位,發個訊息給參加成員說那一天有個驚喜約會,自動開啟瀏覽器搜尋餐廳當天是否有特殊菜色,以及規劃導航到餐廳的路徑等等。
而在這些多個模型的執行效能部分, C2-Ultra 搭配 SME2 引擎在首個 Token 的產出時間也比上一代要快了 25%。
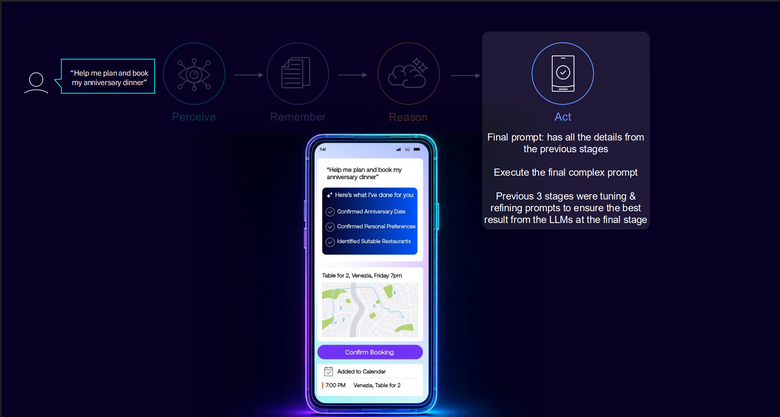
最後就是依照所產生的提示詞進行處理的結果。
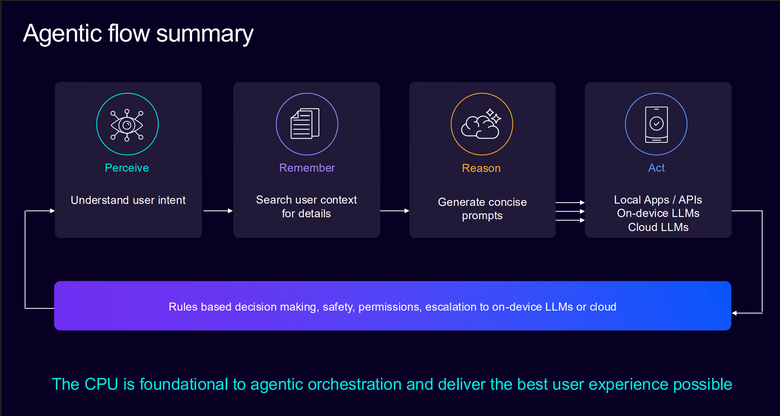
再度總結整個運作流程,從理解使用者的意圖(感知)、搜尋使用者的細節資訊(記憶)、生成精準的提示詞(理解)到依照提示詞在裝置端/雲端應用或是模型上進行運作(動作),形成一個完整的 AI 代理運作流程循環,而在裝置端進行運算的優勢就在於可以提供更快速低延遲的反應以及確保隱私。
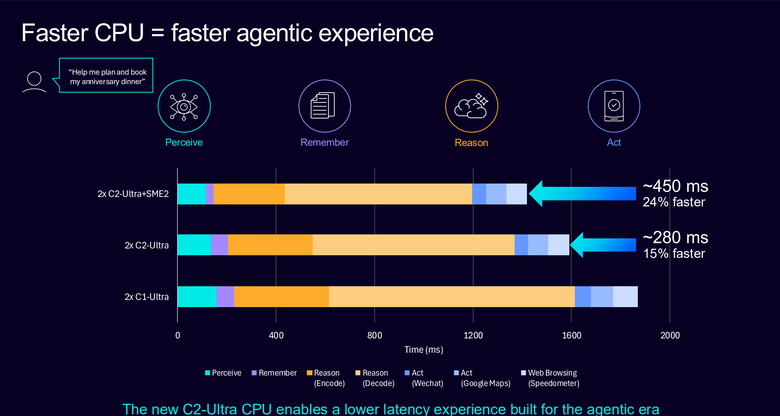
而更高效能的處理器所帶來的就是更快的 AI 代理使用體驗,尤其是在延遲時間的縮短上,C2-Ultra 比起上一代可以提供 15% 的延遲時間縮短,而在加入 SME2 引擎的配合之後,更可以有 24% 的延遲時間縮短。
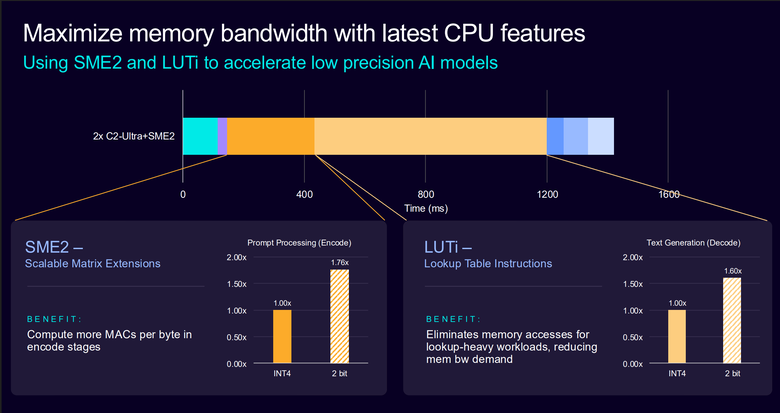
這部分的效能提升來自 SME2 引擎以及 LUTi 指令集所帶來的效益,分別在提示詞處理(編碼)以及文字生成(解碼)的部分,對於精度要求較低的模型可以提供更高的加速效能。
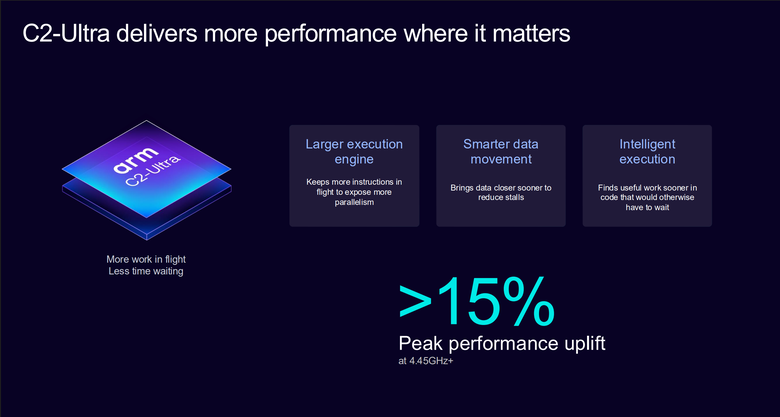
接著對 C2-Ultra 核心做更詳細的解說,在這次 Arm 在 C2-Ultra 核心部分使用了更大的執行引擎、更聰明的資料轉移方式以及智慧執行器等更新設計,提供了最高 4.45 GHz 的運作時脈,在峰值效能上比起上一代要提升 15% 以上。
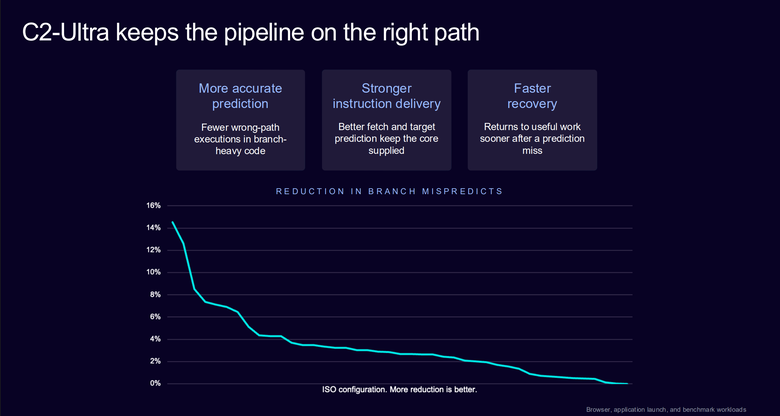
另外在 Pipeline 部分也做了最佳化設計,提供更精準的分支預測、更強的指令傳遞以及更快速的回復速度,讓整個指令的運作更有效率。
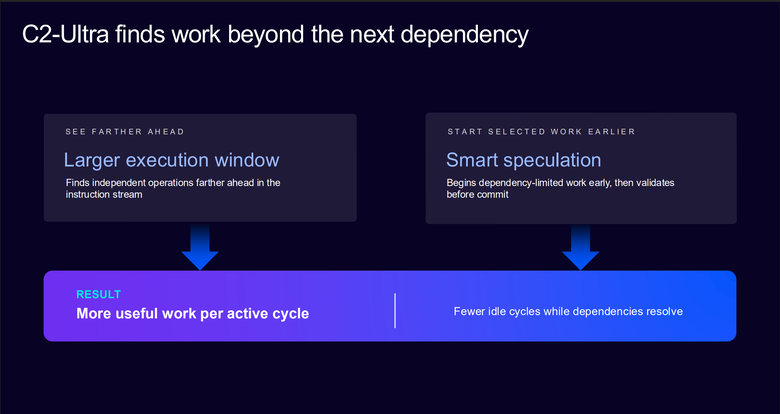
在執行窗口以及預測上的設計也經過改良,不僅提供更有效率的運作,也減少閒置 cycle 的產生。
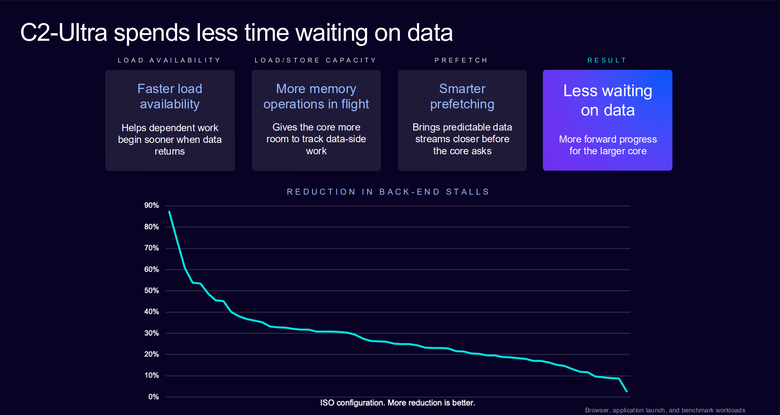
在後端資料處理的部分,則是透過更快的載入速度﹐加大記憶體窗口以及更聰明的預載(Prefetching)設計,來降低資料等待的時間。
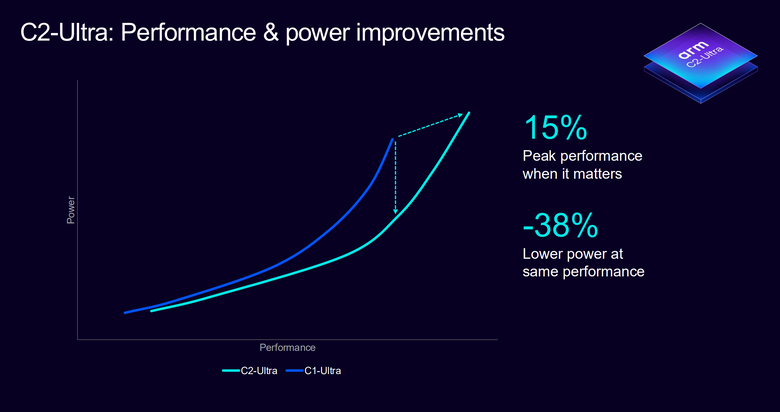
透過上述核心的改良設計,這次 C2-Ultra 核心比起上一代 C1-Ultra 在峰值效能上提升了 15%,在同樣效能設定時,則是比 C1-Ultra 要降低 38% 的功耗需求。
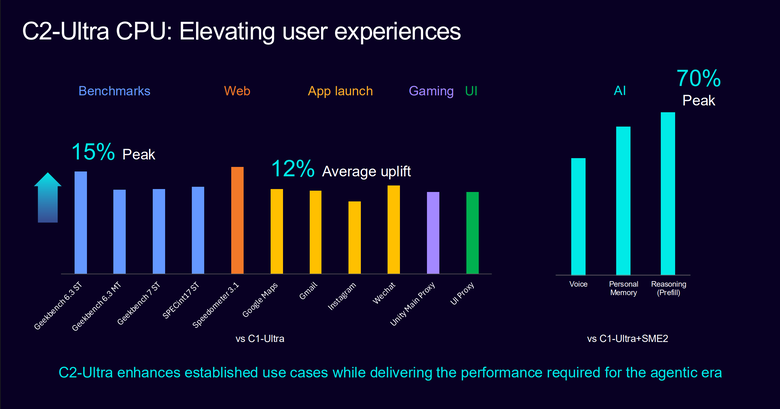
在實際的效能表現上,C2-Ultra 在效能跑分、網頁瀏覽、App 啟動、遊戲跟 UI 執行效能部分,有著 12% 至 15% 不等的平均效能提升,在 AI 部分則是有 70% 的峰值效能提升。
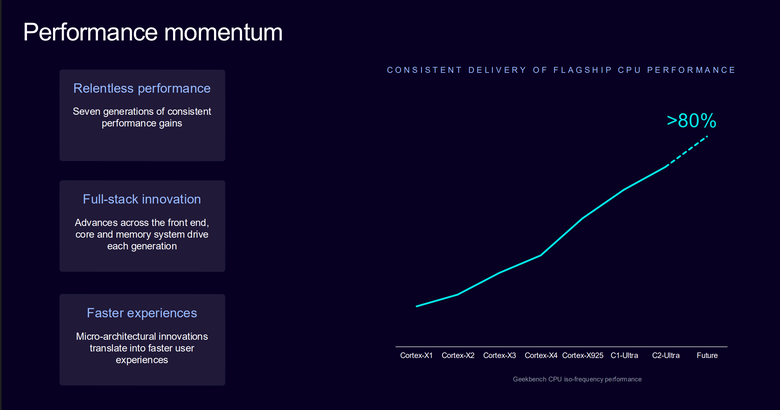
而 Arm 也表示下一代的處理核心也會以這樣的幅度進行效能提升。
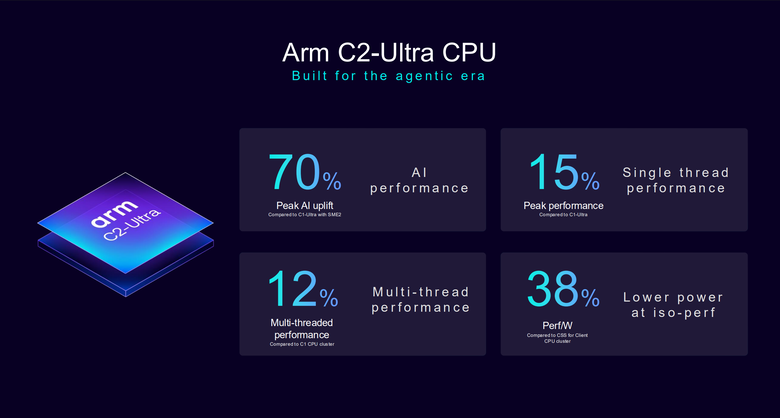
最後來總結一下這次 Arm 新的 C2-Ulta CPU 核心,是專為 AI 代理時代所設計,在 AI 校能部分有 70% 的峰值效能提升,單執行緒部分則是有 15% 的效能提升,多執行緒部分則是有 12% 的效能提升,而在同樣效能設定下的功耗則是降低了 38%。
接下來這幾個月應該可以看到許多採用/部分採用 Arm CSS for Mobile 2 平台的行動處理器產出現,包括聯發科、小米等等,在手機上會呈現更多 AI 代理的方便應用。


 感謝分享&介紹,AI效能越來越看重