

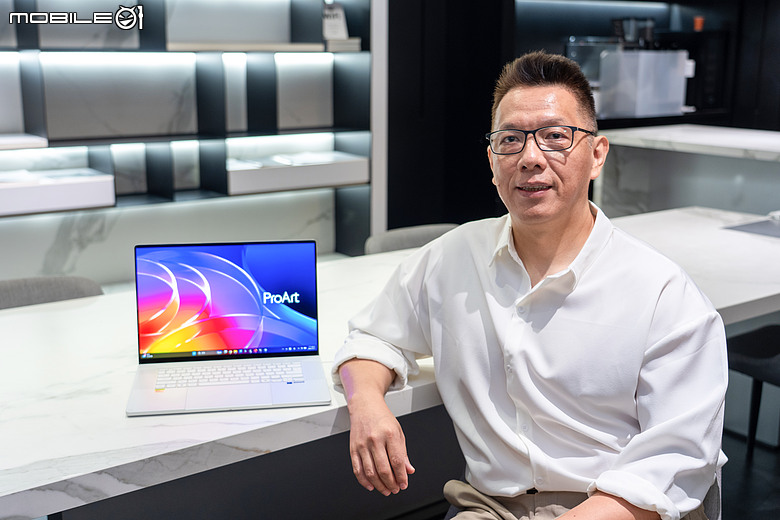
隨著 NVIDIA RTX Spark 筆電在上週開賣,2026 年也正式進入地端 AI 運算世代。過去使用 AI,多半是輸入問題、等待回答,再自己把內容搬進文件或軟體;如今 AI 代理 (Agent) 已能自行拆解任務、呼叫工具,搭配不同模型分工,接手寫作、資料整理與程式開發,甚至是與創意軟體串連。當需要反覆讀取資料、推論與修改內容,雲端用量也跟著累積,把固定、反覆執行的工作交給地端模型,就成了掌握運算資源與資料處理方式的新選擇。
先前陳拔、布萊恩已前往美國舊金山參加 NVIDIA RTX Spark Editors Day,站上也陸續帶來 RTX Spark 平台介紹、AI 代理與效能跑分測試,這次 JB 則從實務角度出發,邀請著作上百本書的 AI 專家胡嘉璽,分享他如何用 Agent 協助寫作、研究與管理行程,並聊聊搭載 RTX Spark 的全新 ASUS ProArt P16/P14,能為這類追求 AI 代理的使用者帶來什麼幫助、如何在真實情境中發揮價值?
胡嘉璽早在 2014 年便投入 AI 相關工作,經歷過製造業缺陷檢測與文件分析等大型專案,目前則活躍於寫作、教學與顧問工作。長期混合使用本機運算設備與雲端模型的經驗,讓他評估 ProArt P16 時格外關注整套既有工具能否無縫銜接,以及哪些工作值得從雲端搬回本機。
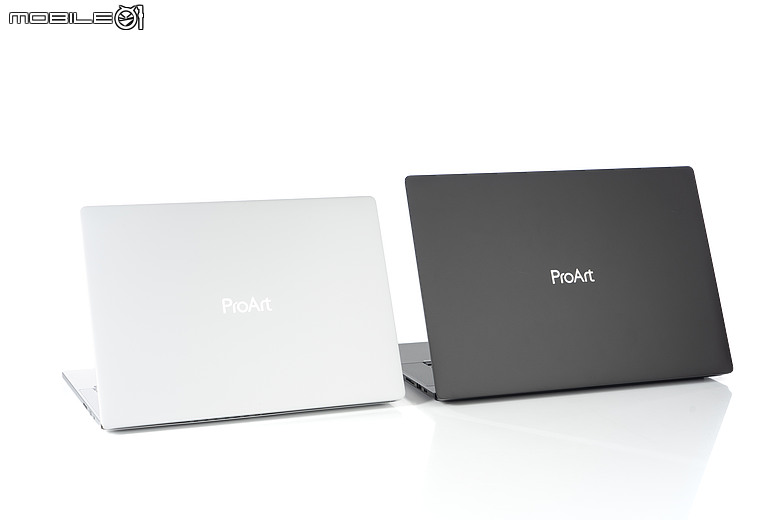
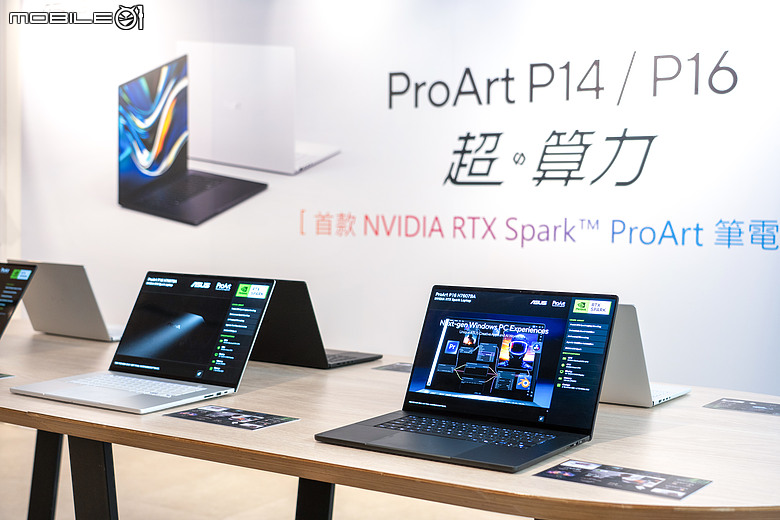
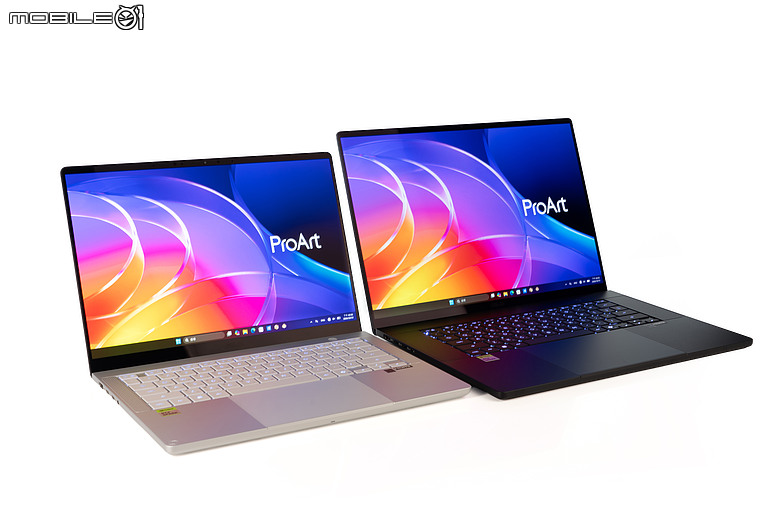
在進入胡嘉璽的 workflow 分享之前,JB 想先談談 ProArt P16 本身的定位。同樣搭載 RTX Spark 平台的筆電,各 OEM 廠也都爭相推出,因此消費者在選購時,還要看螢幕、攜帶性、儲存擴充與軟體配套是否符合自己的工作習慣。ProArt P16 比較吸引我的地方,就在於它把地端 AI 運算能力,放進一台以創作需求為核心的 16 吋筆電裡,對同時需要執行模型、整理素材與檢查作品的人,這些設計會直接影響每天的使用方式。
首先是大螢幕與攜帶性的平衡,ProArt P16 配備 16 吋 4K OLED 觸控螢幕,機身重量控制在 1.77 公斤,最薄處為 12.9mm。以 JB 的角度來看,這套配置的吸引力,在於外出時仍能保有較大的檢視畫面:例如比較不同版本的 AI 生成圖片、檢查人物與物件細節,或是在創作軟體中同時查看素材、預覽與工具面板,都有更充裕的操作空間。螢幕支援 100% DCI-P3 色域與 PANTONE 色彩認證,也延續了 ProArt 對影像創作的重視,對希望把運算與作品檢查都放在同一台筆電上完成的人,螢幕就是值得納入選購的條件。
另一項 JB 認為很實際的設計,是機身提供兩組 M.2 SSD 插槽(包含已使用的插槽),讓後續儲存擴充保有彈性。開始使用地端 AI 之後,除了原本的照片、影片與專案,還會逐漸累積不同模型及生成成果,模型能不能載入記憶體是一回事,這些檔案要放在哪裡,也需要提早規劃,而第二組插槽讓使用者能增加容量,或依習慣分開存放系統與工作資料,減少所有內容都擠在同一顆 SSD 的情況。搭配 SD Express 7.0 讀卡機,對經常帶著相機外出、回到電腦就要匯入素材的創作者而言,這些都是很貼近工作現場的配置。
軟體則是 ProArt 筆電別具品牌特色的部分。華碩自研的《MuseTree》提供創意發想與影像生成工具,《StoryCube》協助匯入、預覽及分類照片與影片,這些配套的價值,在於替使用者準備了幾個明確的應用入口:有靈感時能嘗試生成內容,素材累積後有工具協助整理,進入製作階段也能調整電腦與顯示設定。這些工具讓創作與素材管理都有對應的軟體支援,也成為比較同平台筆電時,ProArt 值得留意的特色。
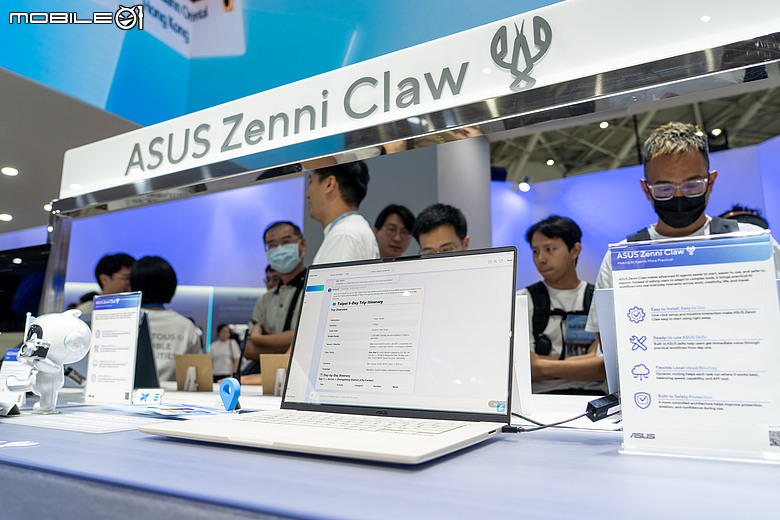
華碩也規劃推出自家的 AI 代理「Zenni Claw」,進一步延伸創作與代理應用的整合;目前功能尚未開放,這就有待日後推出後再檢視完整體驗。此外,ProArt 新機的預購登錄活動也搭配第三方地端 AI 軟體《Armor EdgeAI》。從內建工具到合作軟體,可以看出華碩對軟體生態系的積極投入。至於 ProArt P16 這套配置如何接進已經建立好的 AI 工作流程,胡嘉璽的使用經驗,就提供了更具體的觀察角度。
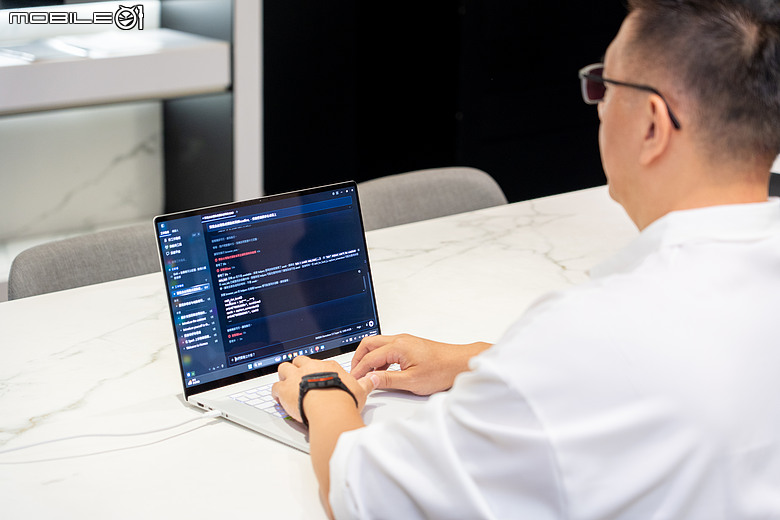
要理解胡嘉璽為什麼需要這類電腦,可以先從準備講課資料的流程看起。他會將自己的用詞習慣、台灣繁體中文要求與事實查核規則,整理成 AI 代理能沿用的工作指引與 Skill。準備講座簡報或上課教材時,先交代主題與內容需求,讓代理研究資料、提出大綱;方向確認後,再協助整理內容與檢查文字,最後由自己逐項閱讀、修改,補上教學所需的經驗與觀點,把關教材的正確性與呈現方式。
準備軟體操作教材時,擷取示範畫面也是一項繁瑣的工作。胡嘉璽會搭配 Computer Use,讓代理點選軟體功能、開啟視窗並擷取圖片,也曾透過遠端連線操作 ProArt P16。將需要的操作步驟與畫面要求交代清楚,便能讓 AI 代理協助完成截圖,最後再由他檢查圖文是否對得上、操作內容是否正確。
這套備課流程採本機與雲端搭配,既有規則與 Skill 也能沿用到本機模型,讓資料準備、內容整理與圖片製作有一致的工作要求。對 JB 來說,這個例子有意思的地方,在於講師把備課過程中反覆出現的步驟整理成流程,交由代理協助處理,自己則保留教學方向與最後品質的決定權。
教材的文字也需要符合講師的表達習慣。AI 產出的內容即使沒有錯字,用詞、語序或語氣仍可能需要調整;如果每次準備資料都要重新交代「請用台灣慣用語、不要出現制式的 AI 腔」,省下的時間又會花在反覆溝通。將確認過的標準保留在工作指引裡,就能讓後續教材沿用,人工檢查發現的問題也能持續補進規則。
在胡嘉璽出差期間,他還直接使用 P16 上的本機代理,協助與旅行社往返溝通改票事宜。先交代希望搭乘的航班與商務艙條件,AI 代理接著就會讀取 Gmail 來信、對照對方提出的方案,以英文接續回覆(是說這裡處理的是改票郵件溝通,模型在本機判讀與生成,信件仍透過 Gmail 連網收發)。他形容 Agent 回信的英文很道地,自己也不必每收到一封信,就停下來重新整理要求、組織英文,自己也可以放心去做其他事情。
文件整理、翻譯與影片字幕,也是胡嘉璽的常用任務。例如交給 AI 代理一個影片連結,再由工具取得素材、處理字幕與摘要,便能把原本分散在不同程式裡的操作串起來。這些案例讓我們看見,當 AI 開始讀取檔案、呼叫工具並接續處理任務,使用者需要的電腦環境,也會跟著改變。
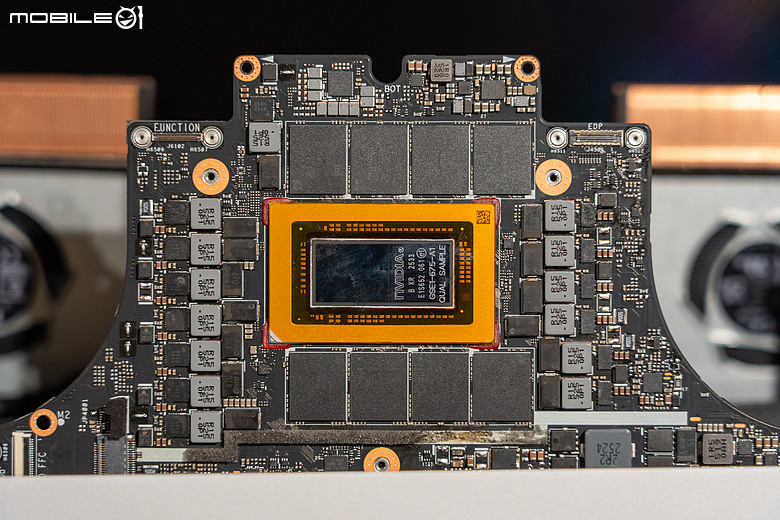
談到這台 20 幾萬元的 RTX Spark 筆電所帶來的改變,胡嘉璽認為方便性明顯大增,他原本就有獨立的本機運算設備(如 DGX Spark 及 mini PC,都是要接上螢幕、鍵盤滑鼠的),但模型部署在另一台機器上,仍需要用電腦連線進去,才能下指令、看結果與處理檔案。ProArt P16 則把模型、128GB 記憶體與日常操作介面放在同一台設備上,適合本機執行的工作,開啟筆電就能接著做。
這也是他看待 RTX Spark 的出發點,平台整合了 NVIDIA Grace CPU、Blackwell RTX GPU 與最高 128GB 統一記憶體,搭配 Windows 工作環境;對胡嘉璽而言,吸引力在於大容量與熟悉的 NVIDIA 開發工具同時到位。過去使用獨顯來跑大型語言模型,他熟悉 CUDA 的便利,卻也碰過顯示記憶體限制模型選擇的問題;換到其他環境(像是 Mac),則得重新考慮框架、套件與工具的銜接。
這種差異,在安裝工作環境時特別有感。他平常習慣透過命令列與 Python 工具串接任務,過去常要找適合的 Python 套件、驅動程式或替代方案,原本只是要完成一件事,卻還要先花時間處理工具能不能用。這次使用 ProArt P16,他以 pip install 為例,形容自己需要的套件能透過熟悉的指令完成安裝,部署過程比過去更為順手。
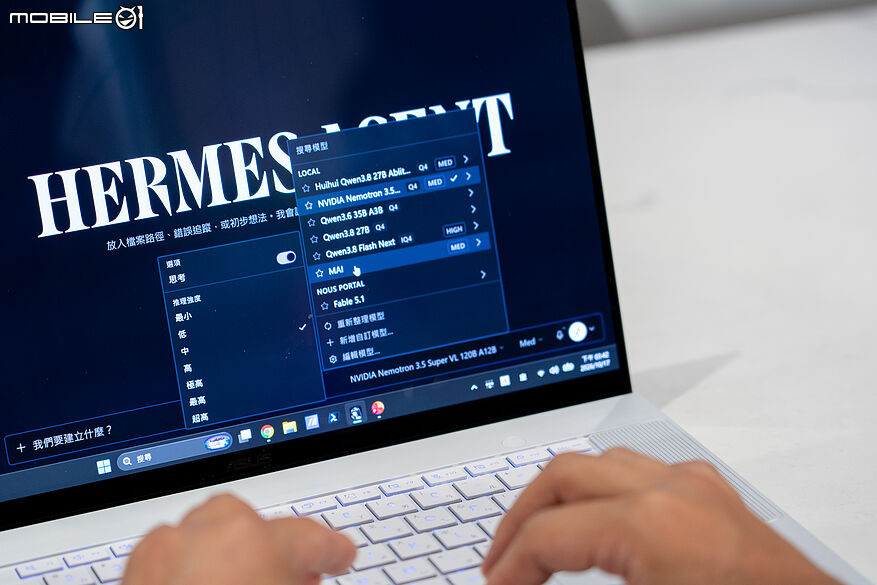
對經常試 AI 模型(上圖為 Hermes Agent 的模型切換示意)、寫程式與調整代理流程的人,少掉這些尋找與設定的工夫,就是很實際的效率;而對開發者,這還延伸到以自有資料集進行小型模型微調的用途,胡嘉璽以企業資料不適合交給外部服務為例,提出在本機準備資料、利用 PyTorch 等工具調整模型,再檢查結果的方向。適合的模型規模與微調方法仍須依資源配置選擇,但同一台設備能兼顧模型使用與開發實驗,正是這類工作者關注的平台價值。
Windows 作業系統則銜接了另一端的日常工作:他需要與學生、同事及客戶交流,代理完成的文件或程式,仍要打開軟體檢查、修改與交付。模型工具與工作檔案在同一台電腦上,便能減少跨設備連線和搬移成果的步驟。
一般高階創作筆電同樣能執行本機 AI,差別首先在於能容納什麼規模的模型。傳統獨顯配置將系統記憶體與顯示記憶體分開,即使筆電裝有大容量記憶體,GPU 的專用顯示記憶體仍有自己的上限。以 NVIDIA 官方規格為例,GeForce RTX 5080 Laptop GPU 配備 16GB GDDR7 顯示記憶體,RTX 5090 Laptop GPU 則為 24GB,這與筆電另行配置的系統記憶體是兩個不同的資源池,系統記憶體很大,並不等於 GPU 同時擁有相同容量的專用顯示記憶體。
可以用一個簡化的計算理解這件事。假設一個 700 億參數模型的全部權重都以 4-bit 儲存,光是權重的理論資料量就是約 35GB,而 1200 億參數則約為 60GB,這還沒算量化所需的額外資料、推論暫存與上下文。這是容量示意,不是特定模型的實測占用,但已能看出為什麼有些模型即使經過量化,也放不進 24GB 顯示記憶體。
一般獨顯筆電仍能透過 CPU 與 GPU 混合推論,把部分模型留在系統記憶體,或選擇較小模型、調整量化與上下文設定,像 llama.cpp 就支援 CPU+GPU 混合推論。但這些做法也讓使用者必須在模型規模、速度與記憶體配置之間取捨,無法只靠換上一顆更高階的 GPU,就直接跨過容量限制。
ProArt P16 的 RTX Spark 則將 Grace CPU、Blackwell RTX GPU 與最高 128GB 統一記憶體整合起來,讓 CPU、GPU 工作共用記憶體資源。128GB 仍須供作業系統、應用程式及推論使用,並非全是模型專用空間,而它帶來的實際改變,是將可供模型與工作資料運用的容量,拉到不同於一般高階筆電獨顯的規模,這也回答了它與前者的差異:它讓較大規模的本機 AI 工作,有機會在隨身電腦上安排,不必每次都為了容量縮小模型或轉往其他設備。
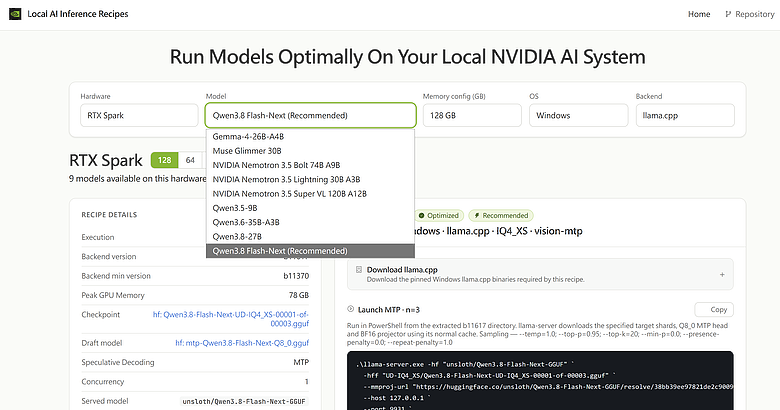
在 64GB 與 128GB 之間,胡嘉璽建議有 AI 代理需求的人「直上 128GB」。他的理由是,既然買這台電腦的主要目的包含本機模型,就希望先保留足夠容量,再依工作選擇模型。訪談中,他也透過模型部署參考頁面,查看不同記憶體配置對應的選項,將容量與能採用的模型連在一起。
而 Agent 工作需要的空間,還不只有模型本身。回到前面的備課流程,代理得讀取工作指引、教材內容與修訂要求,也要接收工具回傳的結果;準備示範圖片時,操作的軟體與檔案同樣需要資源。胡嘉璽以 Blender、Premiere 等創作工具舉例,說明模型與應用程式必須一起考慮:模型負責判斷下一步,實際工作仍需由工具完成。
若讓多個 AI 代理分工,可以想成同一個模型被分派去扮演不同工作角色,例如一個負責整理教材、一個負責檢查內容,是否能派出子代理、如何傳遞結果,以及每個任務保留多少內容,都與外層執行環境有關。增加 Agent 數量,不一定代表必須在記憶體中複製同樣數量的完整模型,但各自的上下文與推論過程仍會使用資源。
如果工作同時包含文字、圖片與影音,則可能需要載入不同類型的模型。這時,128GB 統一記憶體提供的空間就更有意義:除了模型權重,還要考慮上下文、KV cache 等推論暫存,以及實際執行任務的軟體,能不能把模型載進去是第一步,留出足夠資源讓整個流程跑完,才是工作上的需求;128GB 提供較充裕的配置空間,實際能同時執行的任務,仍取決於模型與應用程式的資源需求。
胡嘉璽也談到自己安排任務分流的做法,依照工作難易度,交由本機、區域網路中的運算設備或雲端模型處理。對他而言,沒有必要把每個簡單任務都送到最高階的模型,模型選擇可以隨需求改變,而 ProArt P16 則成為這套環境中,能隨身攜帶並執行本機任務的一端。
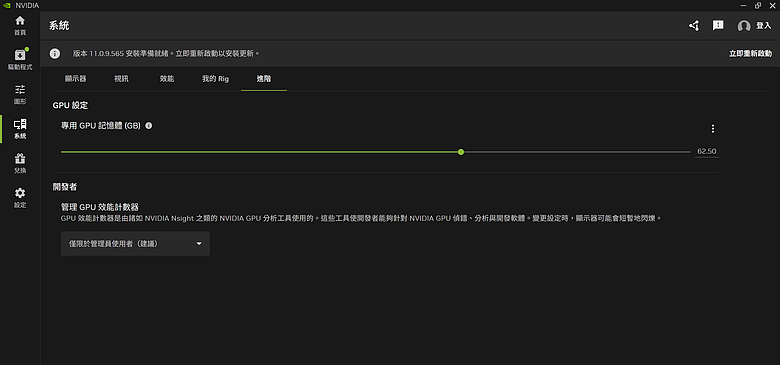
實際分配方面,胡嘉璽也肯定了《MyASUS》的預設動態配置(當然也可以用上圖的《NVIDIA APP》調,128GB 記憶體的版本最高可以設定至 96GB),事先把容量固定切開,反而可能讓某個環節遇到上限,這項心得也很貼近他的工作方式:任務會在備課、工具操作與素材處理之間切換,他希望資源能配合工作,不必一直手動重設。
記憶體容量提供選擇空間,執行速度則仍要看模型、推論軟體與實際任務。對模型原本就能完整放進獨顯記憶體的工作,不能直接以 128GB 推論它一定更快(一些較簡單的任務反而用小模型來跑會比較有效率);胡嘉璽優先選大容量,主要是希望較少受到模型部署空間的限制。
談到 AI,很多人第一個想到的是 Token 費用,但胡嘉璽更重視資料如何處理。他以涉及攝影機控制資訊的保全系統開發為例,說明遇到客戶機密不適合交給外部模型服務的專案,就會選擇本機處理。即使比常用雲端方案花更多時間,只要能完成任務,仍符合這類工作的優先順序。
他也提出企業文件整理的情境:同一項工作可能有多份 Word、Excel、PDF,還有要對照的照片,內容包含個資與內部資訊,承辦人希望利用 AI 歸納,卻不能隨意把整批資料上傳。這時,本機模型搭配文件工具,就提供了在自有設備上整理內容、準備摘要與報告的方式,再交由人員核對。
為了讓 AI 代理能在適當範圍內工作,他則採用 Sandbox (沙盒)的方式限制代理能接觸的資源,將可讀取的資料夾、可使用的工具及網路存取範圍先界定清楚,才能讓代理能力配合工作要求。本機部署的價值,在於使用者能更直接安排資料與執行環境;需要連網收信的任務,與處理敏感專案的任務,也應各自設定合適的存取方式。
這並不代表他已經把全部工作搬離雲端,依胡嘉璽的自述,目前大約採七成雲端 AI、三成地端 AI 的配置,本機常處理文件、翻譯與字幕,較高難度或要求速度的程式工作則經常使用雲端。反覆執行且適合本機 AI 的推論,可以減少這部分對雲端 Token 用量的依賴;當遇到需要高階模型能力的工作,仍保留雲端資源。
這樣的分工,也讓 ProArt P16 的用途更明確。使用者可以依資料性質與任務需求決定執行位置,而不用因為手邊只有雲端服務,就把所有內容採取同一種處理方式,對有客戶專案、內部文件或其他資料管理要求的人,這份選擇權比單純計算每次推論費用更重要。
平台與模型能否配合,是開始使用的條件;每天願不願意帶著這台電腦工作,則與硬體(螢幕、鍵盤)及行動使用感受有關。胡嘉璽對 ProArt P16 的第一印象,就是機身外觀完全對得起 20 多萬元的售價,後續使用也特別肯定鍵盤的打字手感。對需要長時間整理與修改教材的人,即使代理已協助準備內容,最後仍要自己閱讀、修正與補充,鍵盤每天都用得到。
大螢幕也是他明確提到的優點,尤其閱讀文字時更舒服,ProArt P16 配備 16 吋 OLED 觸控螢幕,對他的教學工作而言,閱讀教材、對照資料與確認操作圖片,都需要足夠的觀看空間。代理協助整理內容與圖片後,仍由他在同一台電腦上完成檢查,這也讓螢幕成為整段備課流程的一部分。
續航方面,他分享,在沒有大量執行本機 AI 的一般授課情境下,P16 能支應一整天使用,不需要一直找插座。需要進行地端 AI 推論時則是另一種負載,訪談現場展示 Hermes Agent 運行也能聽到風扇轉速提高。因此,這裡的一整天是他的授課經驗;他的日常節奏包含上課、備課、文件處理與啟動本機模型,筆電需要配合不同工作的切換。
行動使用的價值,也不限於旅途中臨時處理事情。胡嘉璽提到居家與辦公室之間的工作轉換,當模型、工具與專案放在同一台筆電裡,就能帶著原有環境移動;若模型、檔案與所需工具已準備好,不依賴外部服務的任務,也能離線進行。相較於每次都要連回另一台運算設備(如胡嘉璽家中的 DGX Spark),這種安排更符合他想把工作電腦直接帶走的需求。
模型與素材累積之後,儲存擴充也有實際用途。ASUS 台灣官方規格列出 ProArt P16 共有兩個 M.2 2280 插槽(包含已使用的插槽),可供規劃後續儲存配置。不同模型版本、量化檔案與工作素材都會占用空間,選購時除了記憶體,也要替長期保存的資料留位置~
胡嘉璽對 ProArt P16 的肯定來自他已經知道自己要用 AI 做什麼,寫作規則、備課所需的工作指引與工作方式都已建立,他需要的是能容納合適模型、接上既有開發環境,也能每天帶著使用的電腦。RTX Spark 筆電提供大容量統一記憶體與 NVIDIA 工具生態的組合,ProArt P16 的操作與行動條件則讓這套環境更容易進入日常。
除了已經使用本機地端 AI 代理的人,他也看好有自有資料集、想調整小型模型的開發者與研究者,這類用途需要依模型規模與微調方法安排資源,但反映出他對產品的另一項期待:同一台設備除了使用模型,也能承接合適規模的開發實驗。
對讀者而言,選購時可以從自己最常執行的一段完整工作開始,確認需要的模型、工具與資料量,再判斷容量和機身是否合適,需要較大型本機模型,又經常做研究、管理知識、需要修改長篇內容的人,會比較容易理解他為什麼偏好 128GB 統一記憶體與 ProArt P16 的大畫面;若主要需求仍是一般剪輯、修圖或使用雲端 AI,那倒沒有一定要買到 RTX Spark,一般的 ProArt 也能交付任務(但如果是要用地端 AI 去串創意應用的情境,就會很需要了)。
這次訪談最值得留下的,是胡嘉璽對「方便」的具體解釋:少花時間找工具的替代方案,少在不同設備間搬移工作,也讓適合留在本機的任務有地方執行。當這些麻煩正好出現在你的工作裡,ProArt P16 的價值就會比一串規格數字更清楚了。
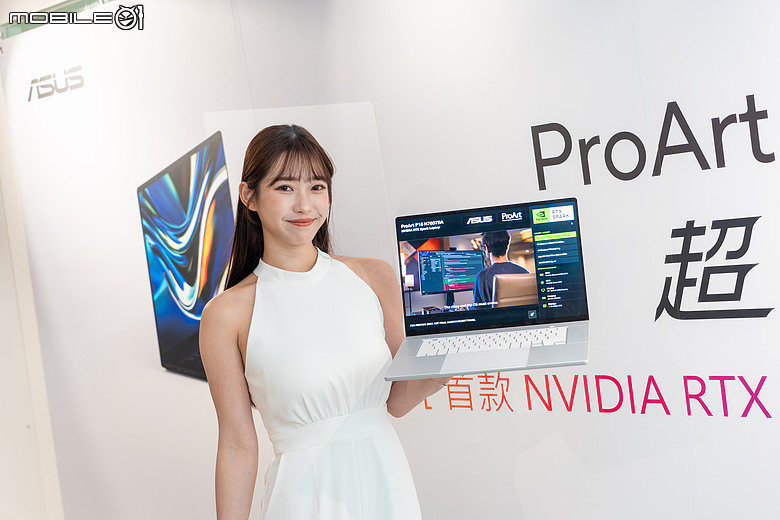
對於清楚知道自己要用 AI 做什麼、追求極致工作效率與完整工具鏈的專業人士來說,華碩 ProArt 系列或許不是價格最低的選擇,卻是將 RTX Spark 平台潛能發揮得最為全面、且軟體體驗最完整的旗艦之作。
最後,對 NVIDIA RTX Spark 平台、或是 ASUS ProArt P16 (64GB 記憶體版本)效能感興趣的朋友,也可參考陳拔與布萊恩兩位大大的測試文:
【Part1】要價超過 18 萬的筆電能玩什麼?NVIDIA RTX Spark Editors Day 美國舊金山現場揭密
【Part2】要價超過 18 萬的筆電能玩遊戲嗎? NVIDIA RTX Spark 遊戲效能實機測試
【Part3】要價超過 18 萬的筆電能幫你自動剪影片? NVIDIA RTX Spark AI 新手實戰
NVIDIA RTX Spark 輕薄筆電測試報告|AI 生成、內容創作與遊戲效能真能一機搞定?!

 感謝分享&介紹,ASUS ProArt P16 下單就對了














