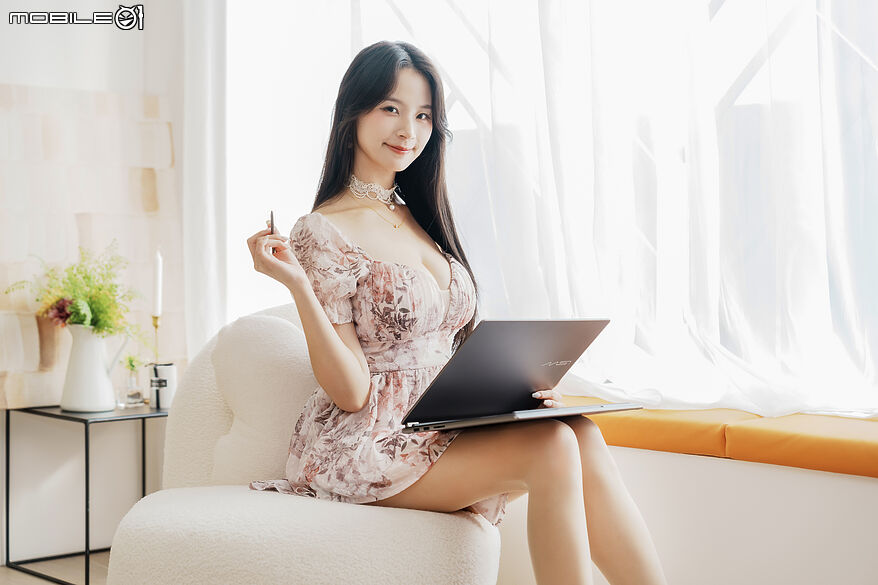
NVIDIA 在本月 16 日正式宣布 RTX Spark 筆電系列在台灣上市開賣,全球各大筆電品牌也紛紛加入這場新品盛會,包括 ASUS、Dell、HP、Lenovo、Microsoft 與 MSI 全球六大筆電品牌,共推出了九款搭載 NVIDIA RTX Spark 超級晶片的筆電新品搶市。布萊恩這次就為各位帶來由 MSI 推出的 Prestige N16 Flip AI+ 筆電的實機測試報導,其搭載具備 20 核心的 NVIDIA Grace CPU,以及擁有 6,144 個 CUDA 核心的 Blackwell RTX GPU,並搭配 128GB LPDDR5X 統一記憶體與 1 Petaflop FP4 AI 運算效能。
此外,布萊恩這次測試的則是系列筆電最高階機型,配置 16 吋 UHD+ Tandem OLED 顯示螢幕,支援最高 120Hz 更新率、100% DCI-P3 廣色域與觸控功能,並通過 VESA DisplayHDR True Black 1000 認證。在筆電內部也導入 Vapor Chamber 均熱板與 Intra Flow 散熱設計,並內建 99.9Wh 大容量充電式鋰電池與 140W USB-C PD 充電器,同時也支援全新 MSI Nano Pen 觸控筆,搭配 360 度可翻轉螢幕的機身設計,讓使用者能在四種不同的使用模式下,順利完成各種工作與創作情境。
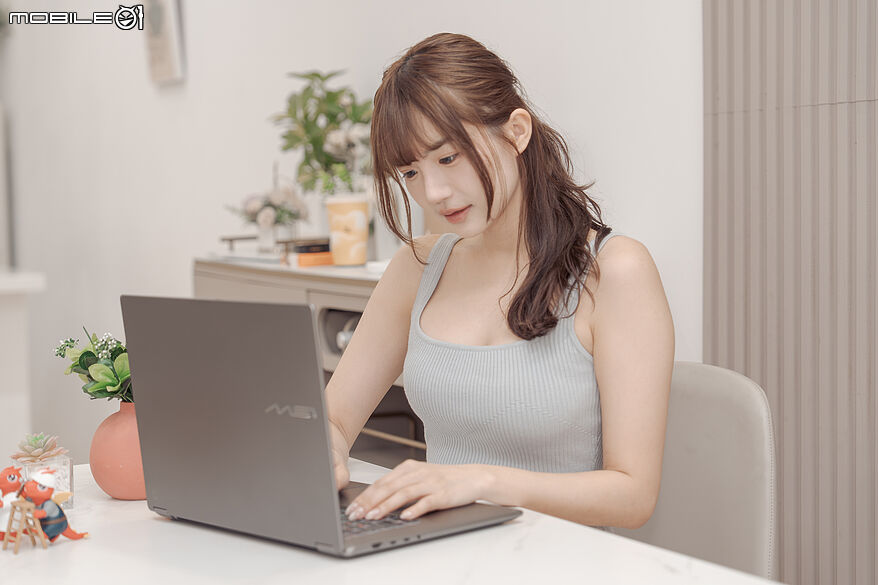
全新的 MSI Prestige N16 Flip AI+ 可以說是 MSI 在今年推出的 Prestige 16 Flip AI+ 的 RTX Spark 版本,除了核心硬體規格配置有所不同外,基本上筆電結構、內部的硬體配置與 I/O 連接埠幾乎都完全相同,因此布萊恩在本篇文章就不多做介紹,如果對外型結構或配置有興趣的朋友,也歡迎到 MSI Prestige 16 Flip AI+ C3MT 測試報告|輕巧大尺寸的效能實力派筆電 這篇文章查閱。
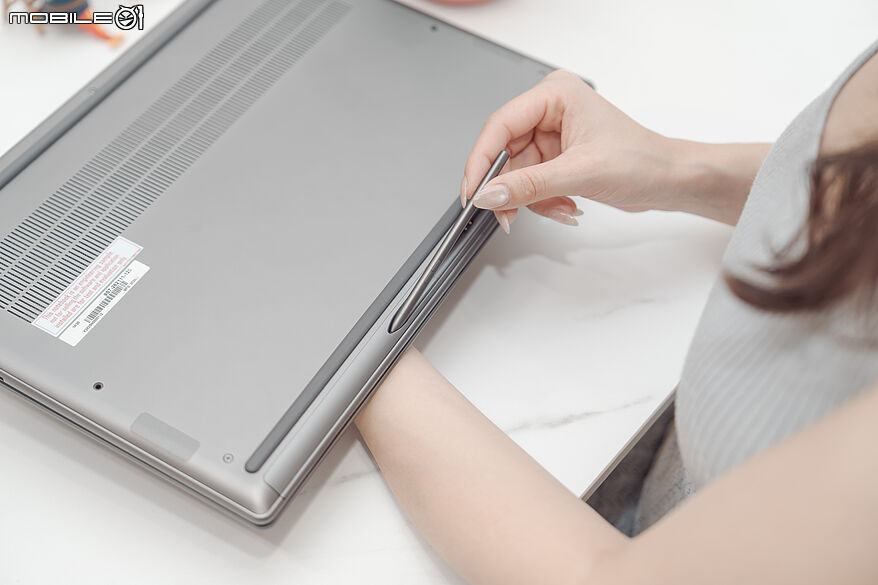
當然,這款筆電也有隨機附上的 MSI Nano Pen 觸控筆,收納與充電的方式與 Prestige 16 及 Prestige 14 相同,同樣也支援 30 秒完整充電,以及 15 秒充電便可使用 45 分鐘的快速充電功能。MSI Nano Pen 觸控筆除標準的操作方式外,筆身上也可看到 MSI 與微軟獨家合作的 Copilot 標誌,使用者可透過內建的 Copilot Press-to-talk 智慧語音功能,只要同時長按筆身上的兩個按鍵後,便能啟動 Copilot 語音輸入功能,為觸控筆增添另一個能快速使用 AI 的操作方式。
- MSI Center S
- 硬體監控
- 全能觸控板
- Mystic Light
- 系統資訊
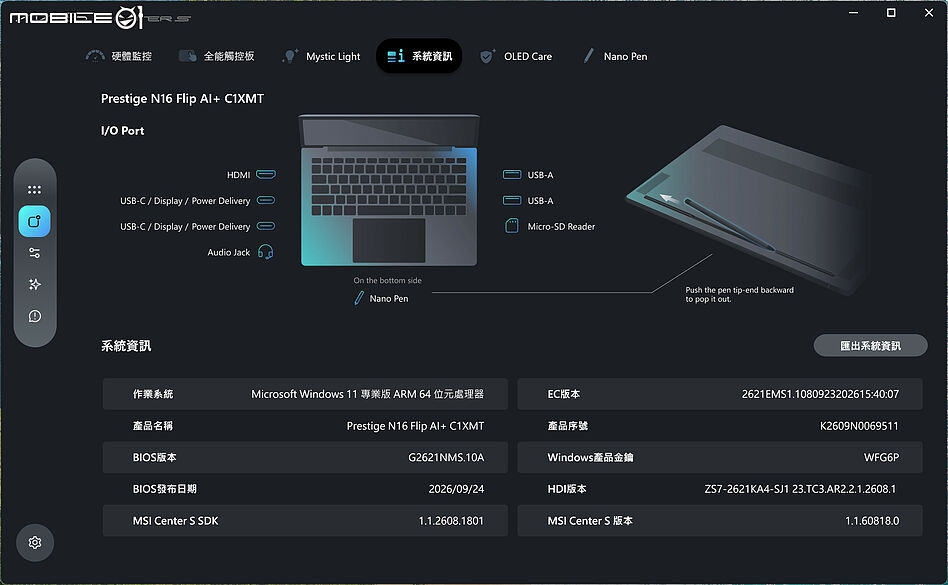
- OLED Care
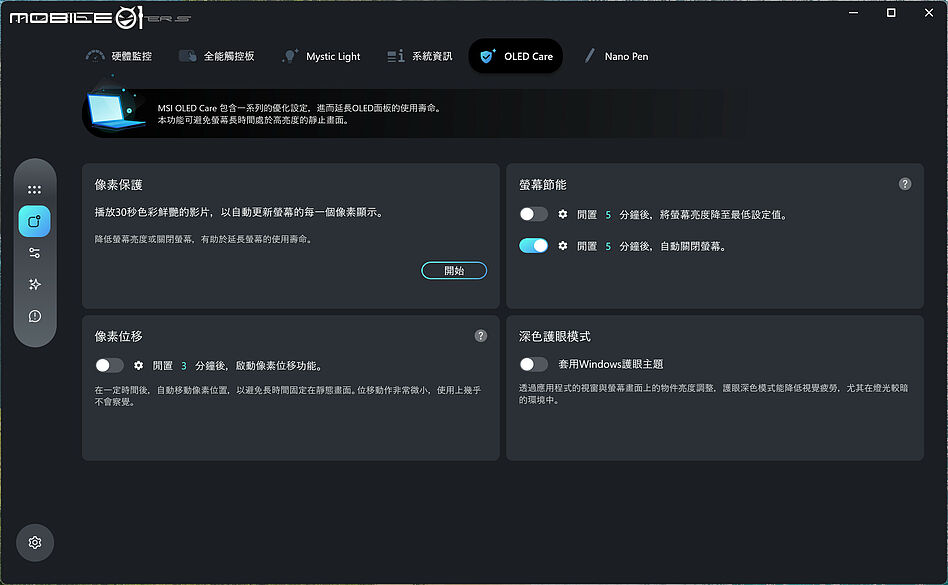
- Nano Pen
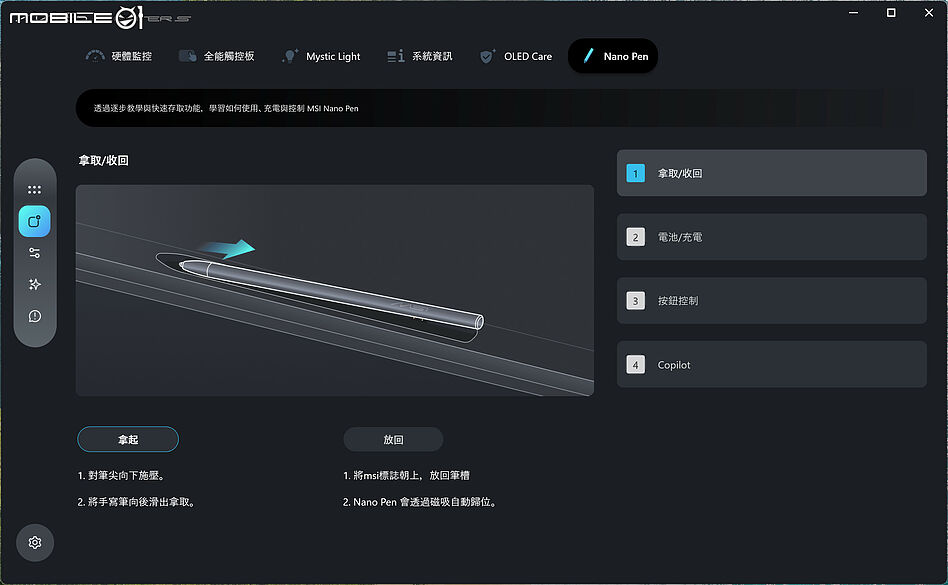
- 基本設定
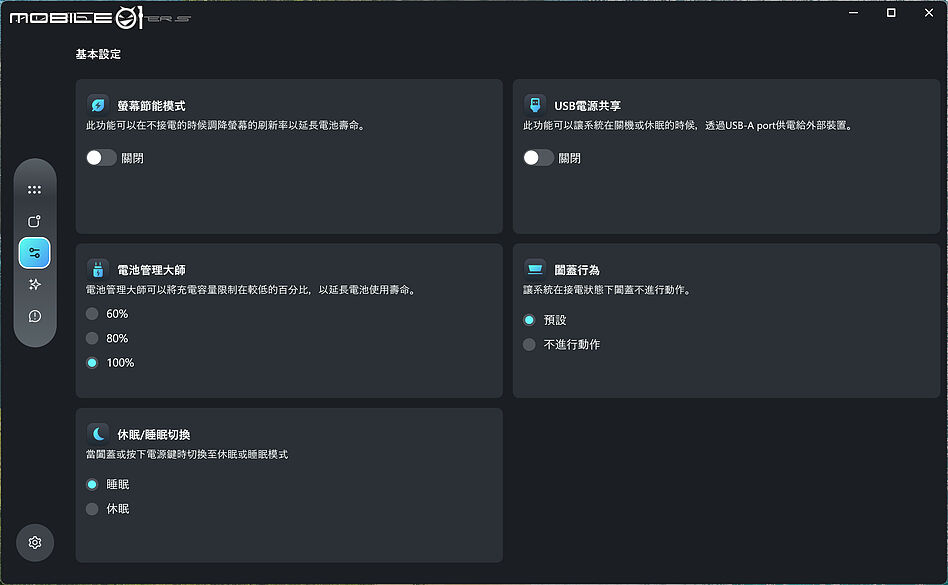
- AI 專區
- 支援
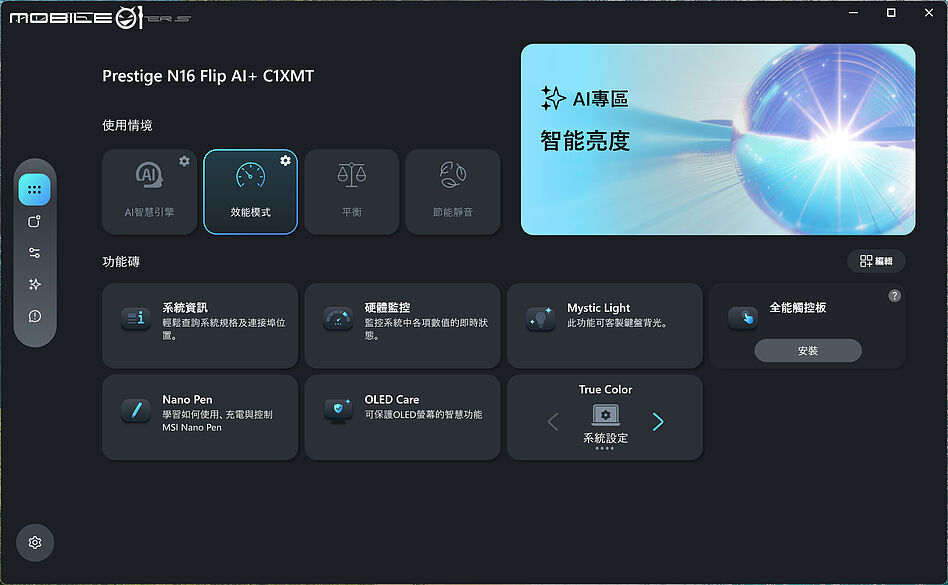
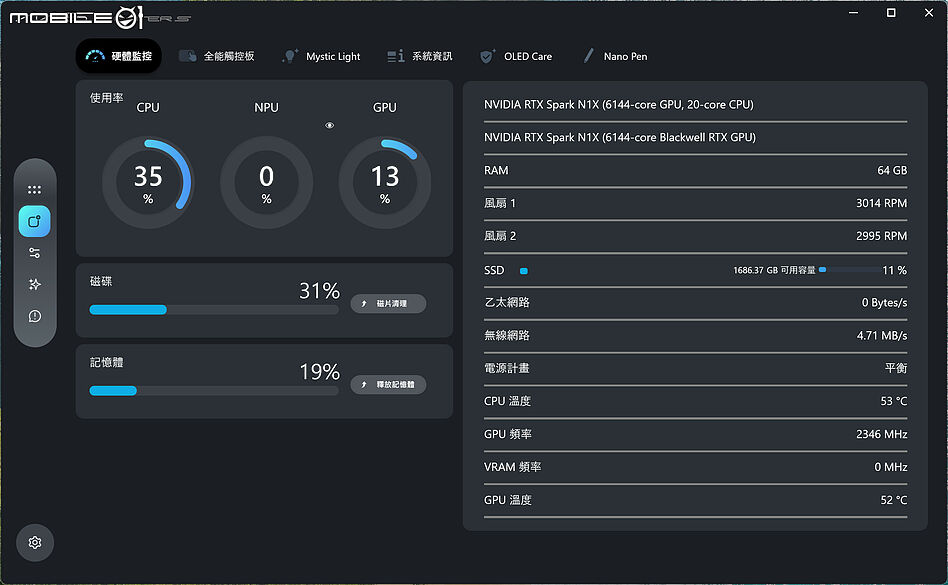
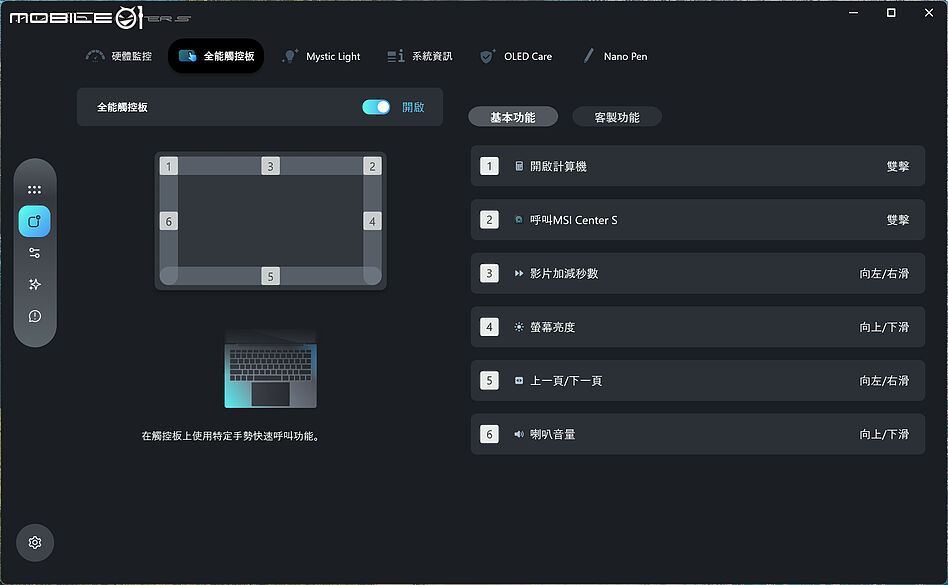
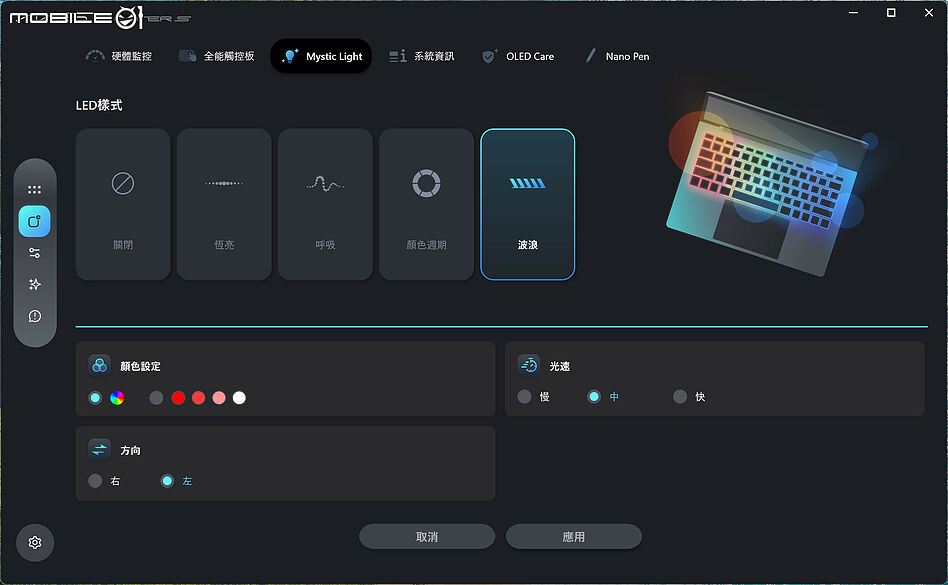
這款 Prestige N16 Flip AI+ 筆電也內建 MSI Center S 應用程式,使用者能夠針對全能觸控板進行個人化操作功能設定,目前僅提供的三向滑動操作,則可選擇螢幕截圖、表情符號、Copilot、小畫家等功能與應用程式選項。此外,觸控版左側上下滑動可進行音量大小,右側上下滑動則可調整螢幕亮度、上側左右滑動則可調整影片秒數,下側左右滑動則可調整網頁上下頁,雖說是基本功能無法客製化,但實用性也是相同足夠。此外,在應用程式中中,也可設定 AI 智慧引擎、效能增強、平衡與節能靜音四種使用情境模式,並可查閱系統資訊與硬體監控等詳細資訊。
MSI 也開放在 AI 智慧引擎與效能增強模式下,進行額外的效能功能設定,像是下方的效能實測我都是使用『效能增加模式』,並搭配變壓器充電來獲取最佳的效能表現,而在電池供電模式下,我建議就是使用 AI 智慧引擎,來讓效能與續航力能夠達到一個最佳的平衡。
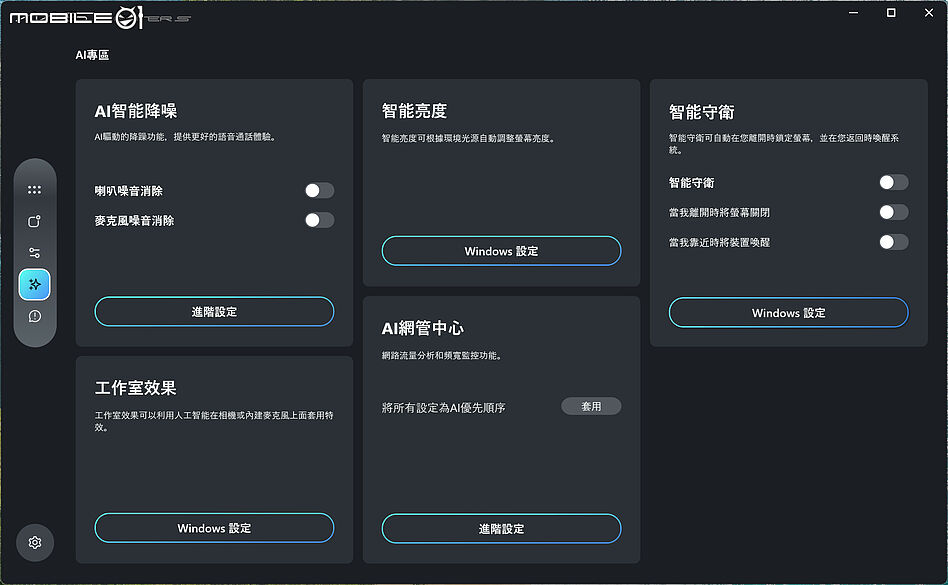
MSI Center S 應用程式中也具備像素保護、像素位移、螢幕節能與深色護眼模式等 OLED Care 功能,另也具備 Nano Pen 觸控筆的拿取收回與 Copilot Press-to-Talk 功能的詳細介紹。至於 AI 專區部分,本次 MSI 也將目前所有提供的 AI 功能整合在同一個頁面,包含 AI 智慧降噪、智慧亮度、工作室效果、AI 網管中心與智慧守衛,加上 AI 智慧引擎使用情境在內,都可以進行進階的設定調整,最後在設定與基本設定中,也有針對電池、USB 電源共享、鍵盤背光等設定選項,主要是用來節省電力的消耗。
- 處理器資訊
- CPU-Z 效能測試
- CINEBENCH 2024 效能測試
- CINEBENCH 2026 效能測試
- X264 FHD Benchmark
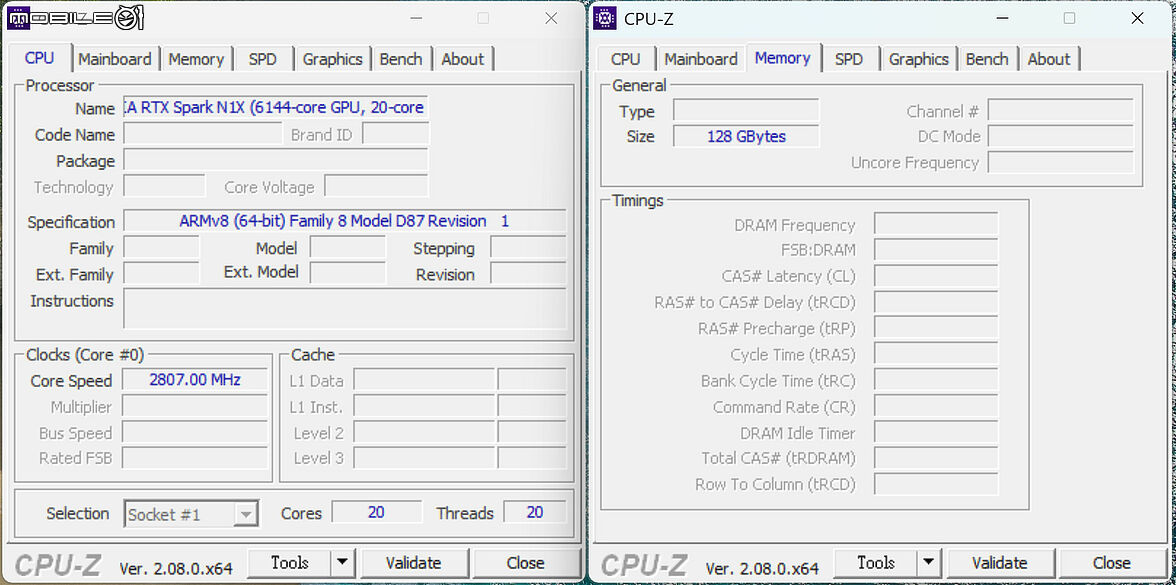
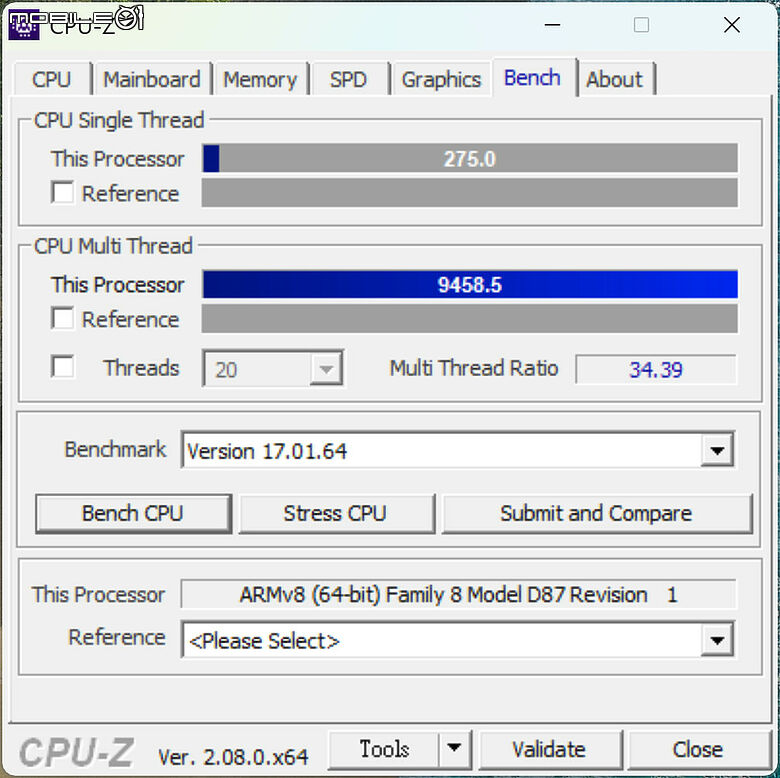
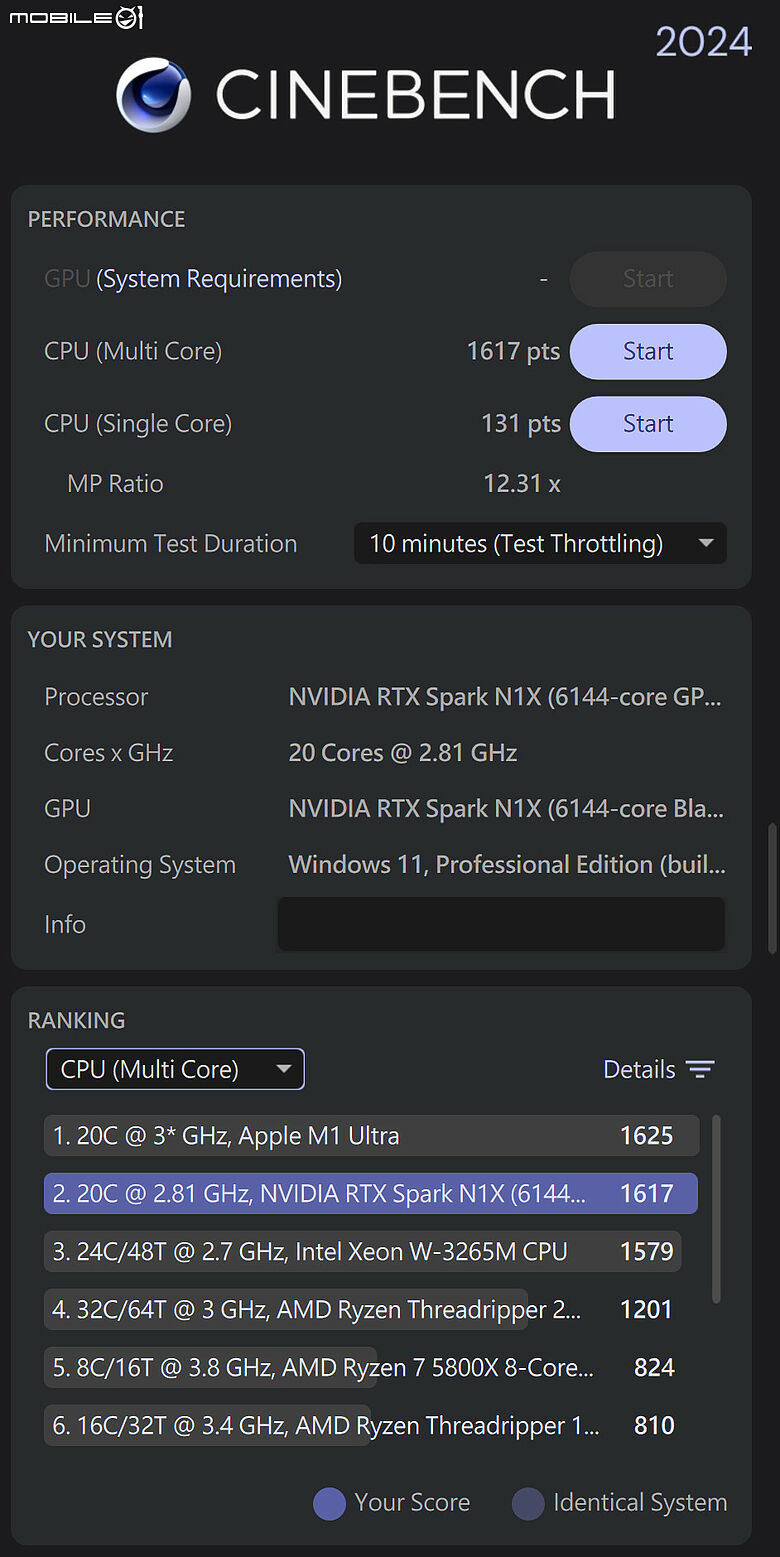
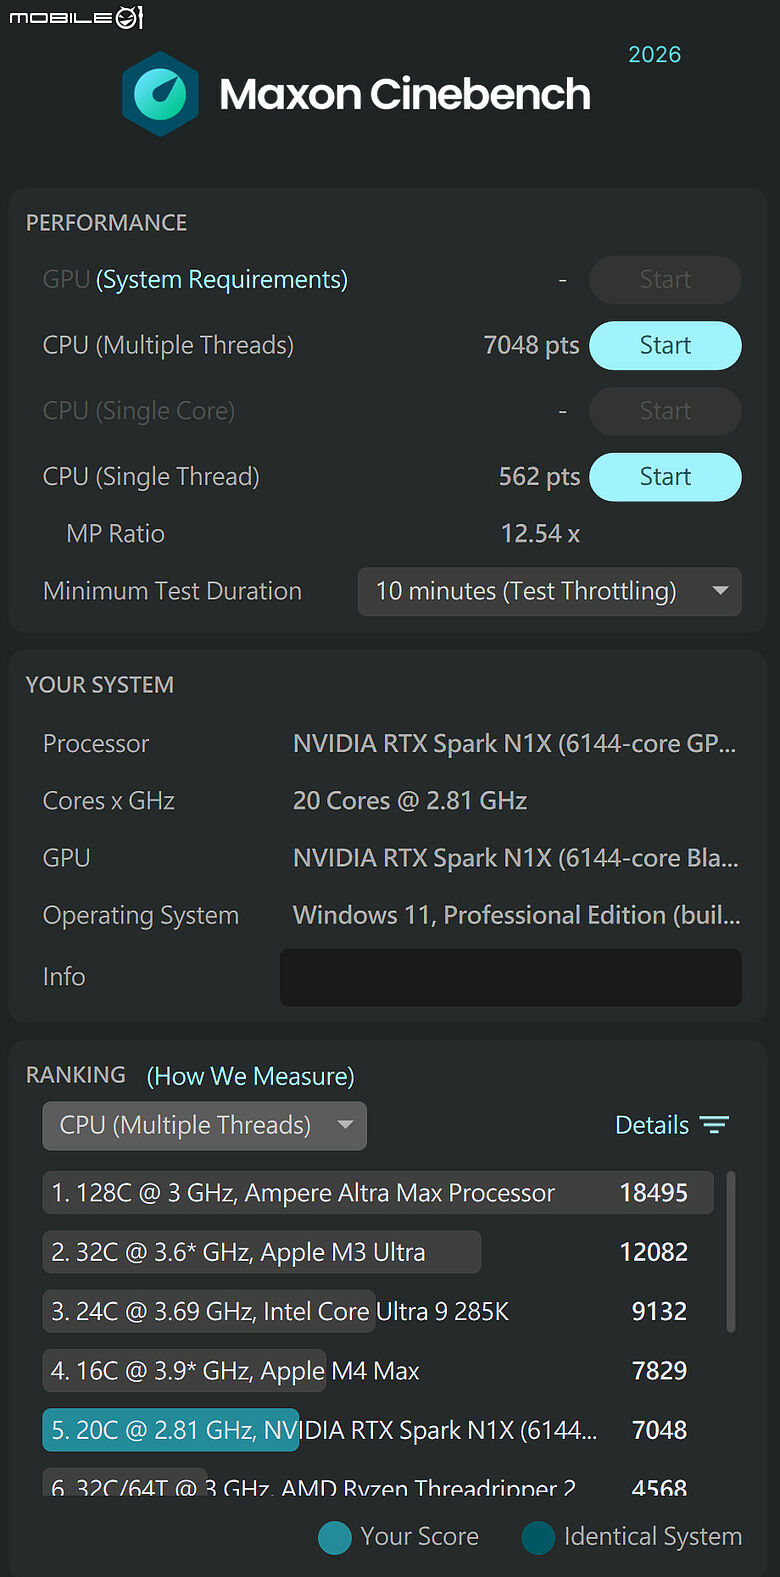
Prestige N16 Flip AI+ 內建 NVIDIA RTX Spark N1X 晶片,為 20 核心的 NVIDIA Grace CPU 與 6,144 個 CUDA 核心的 Blackwell RTX GPU,搭配 128GB 統一記憶體與 2TB PCIe Gen4 SSD 儲存裝置等硬體規格配置。在處理器效能測試部分,我分別使用 CINEBENCH 2024 與 CINEBENCH 2026 兩個測試軟體,其針對多核心執行緒與單核心執行緒的運算效能測試結果如下:
CINEBENCH 2024:單核心 131 分/多核心:1,617 分
CINEBENCH 2026:單核心 562 分/多核心:7,048 分
綜合上方的測試結果,不難看出 NVIDIA RTX Spark N1X 的 20 核心 Grace CPU 在多核心運算方面具備不錯的效能表現,尤其在新版 Cinebench 2026 測試中,不論是單核心執行緒或多核心執行緒,都有接近部分高階桌上型處理器與 Apple M4 Max 晶片的平均效能表現。整體的 CPU 效能也能幫助到實際的多工處理、內容創作與 CPU 渲染時的效能需求。
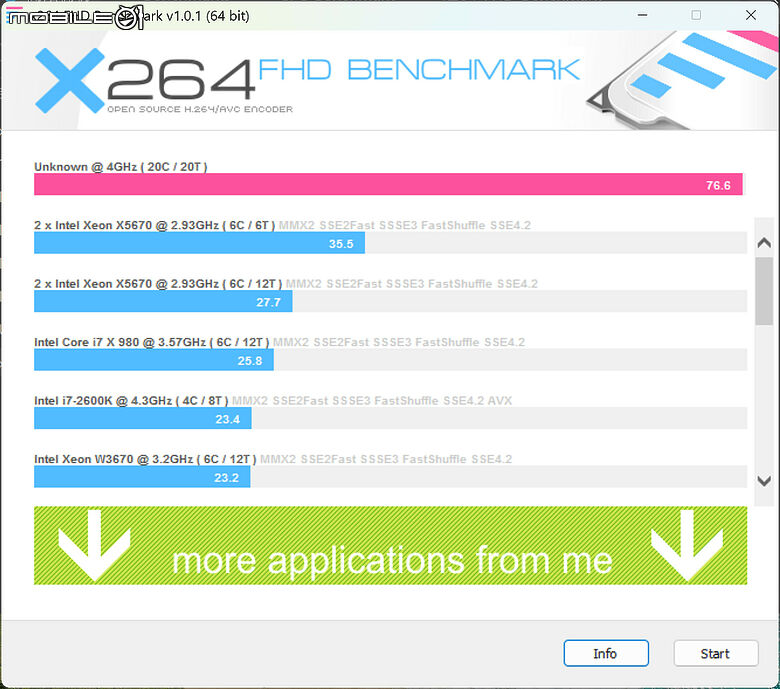
最後,在 x264 FHD Benchmark 的實測中則有著 76.6fps 的編碼速度,這也表示這款筆電,對於影音內容創作者來說,也具備不錯的轉檔與編輯作業效能需求。
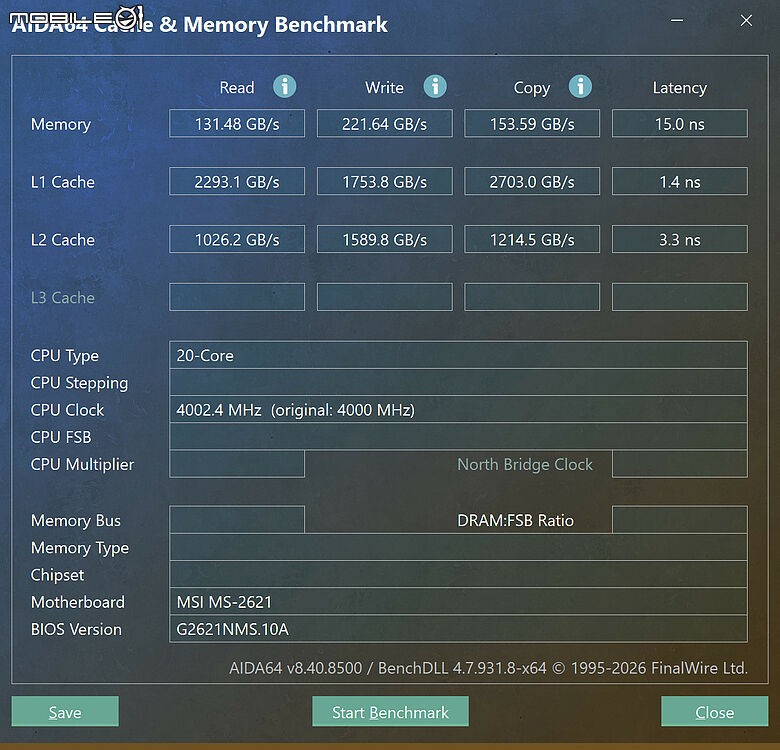
內建 128GB LDDR5X 統一記憶體,在機身內部則具備兩個記憶體插槽,另也採用雙通道架構配置,最大可支援到 32GB 記憶體容量。從 AIDA64 測試結果可以看到,主要記憶體讀取速度達到 131.48 GB/s,寫入速度達 221.64 GB/s,複製速度為 153.59 GB/s,延遲時序為 15.0ns。從實測結果可以看到,內建 128GB 容量的統一記憶體,在讀寫速度與延遲時序的表現上都相當出色,這也能讓使用者在進行多工處理或運行大規模專案,或多個應用程式在背景運行的情況下,都能保持系統相當優異的操作順暢度。
- 硬碟資訊
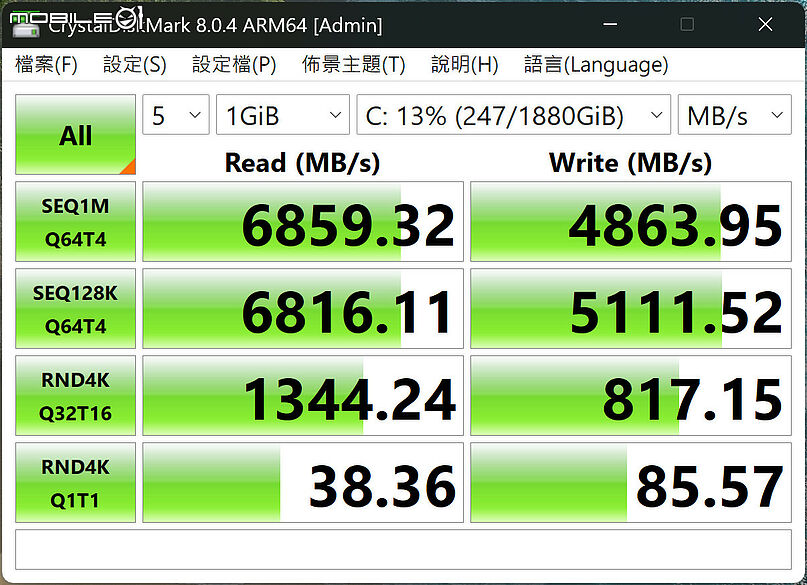
- CrystalDiskMark 效能測試
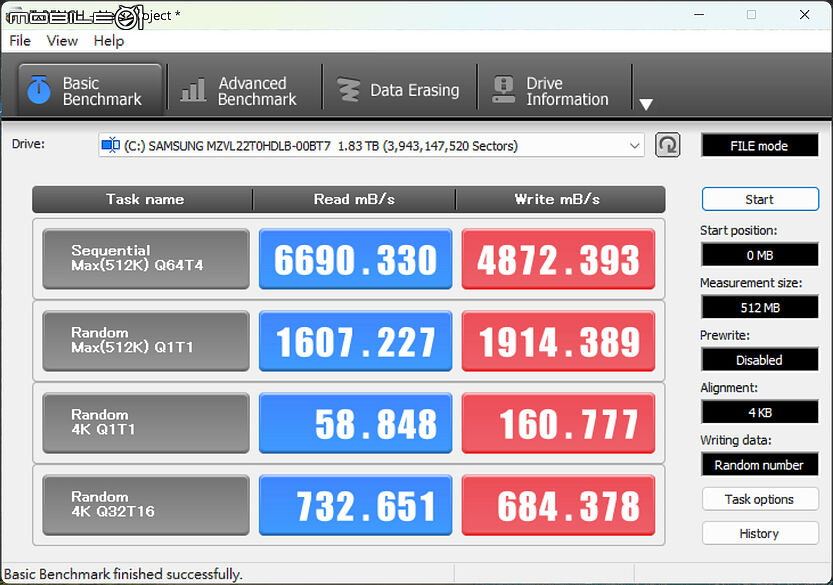
- TxBench 效能測試
- AS SSD Benchmark
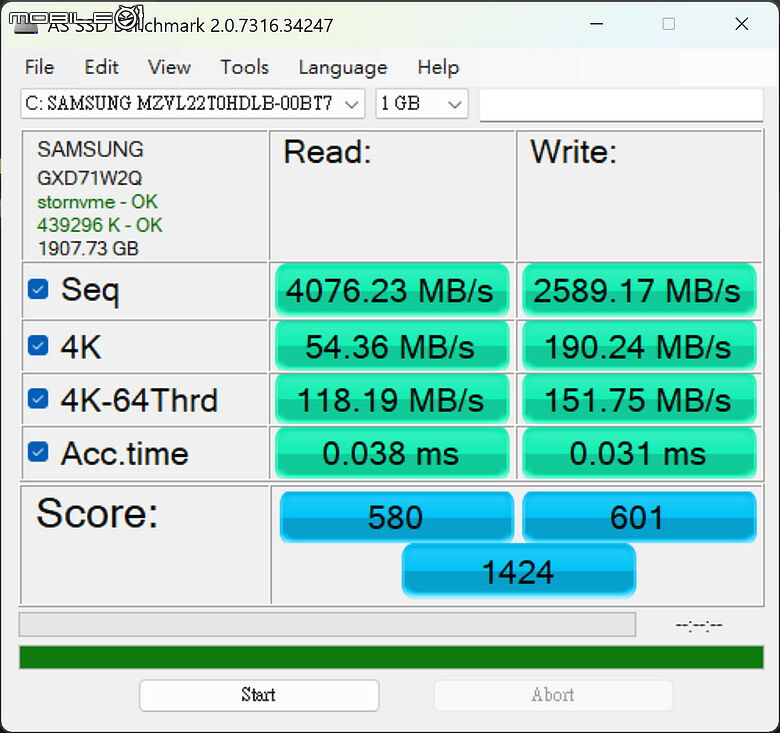
這款筆電則內建 1TB PCIe 4.0 x4 NVMe SSD 儲存硬碟。在效能實測方面,TxBENCH 中的循序讀寫速度為 6,690.330 / 4,872.393 MB/s,而 CrystalDiskMark 則測得 6,859.32 / 4,863.95 MB/s,另外在 AS SSD Benchmark 中的循序讀寫效能表現為 4,076.23 / 2,589.17 MB/s,並測得 0.038 / 0.031 ms 的存取延遲,效能總分則為 1,424 分。
對於有大量資料存取或啟動大型 3A 專案來說,這次內建的 2TB 容量的 SSD 只能滿足基本存取與寫入效能需求的配置,儲存容量空間是沒有太大的問題,但主要還是未來如果能夠支援到 PCIe Gen5 最新的傳輸介面規格,便能夠進一步的強化硬碟讀寫速度的效能表現。
- Speed Way 效能測試
- Steel Nomad 效能測試
- Solar Bay Extreme 效能測試
- Port Royal 效能測試
- DLSS feature Test
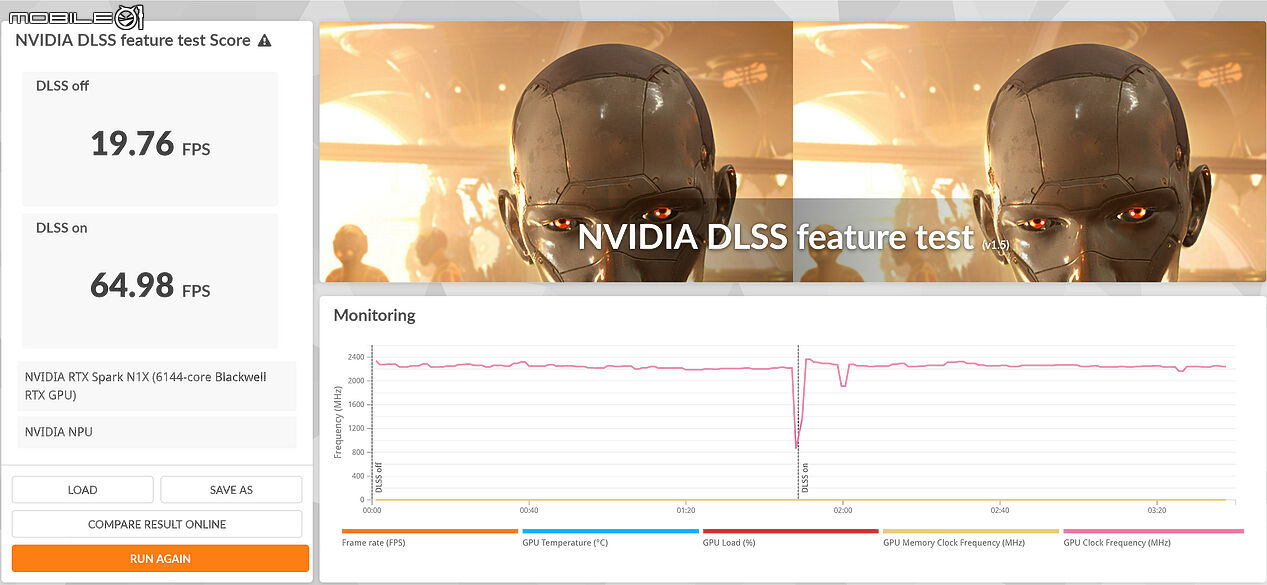
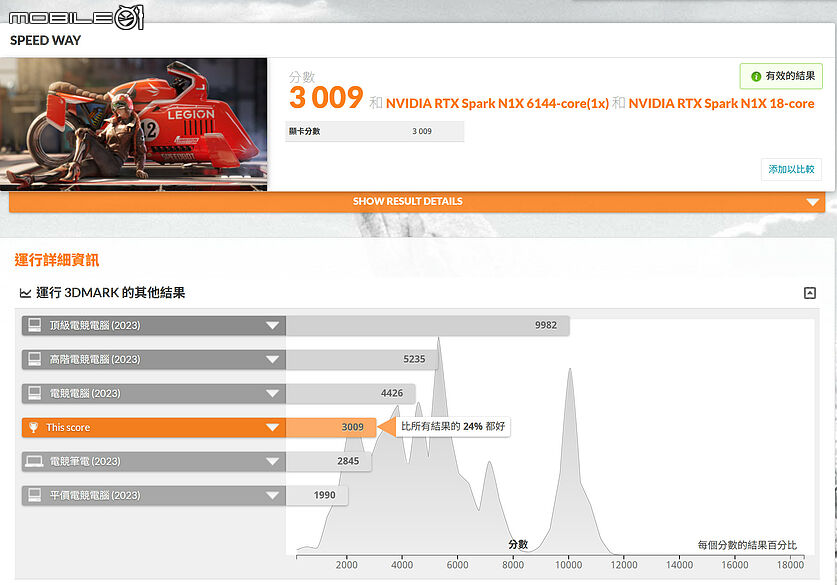
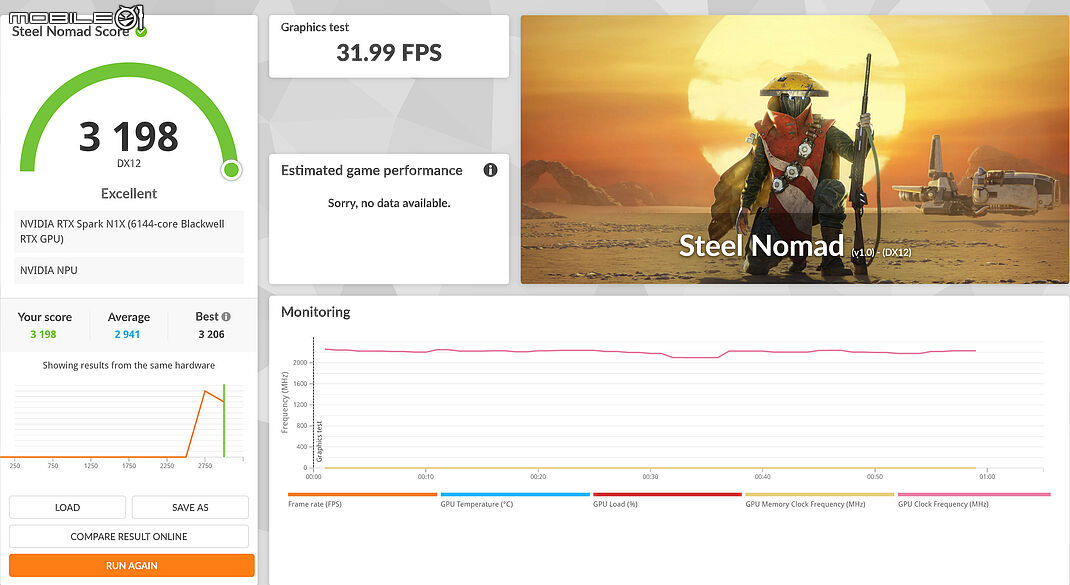
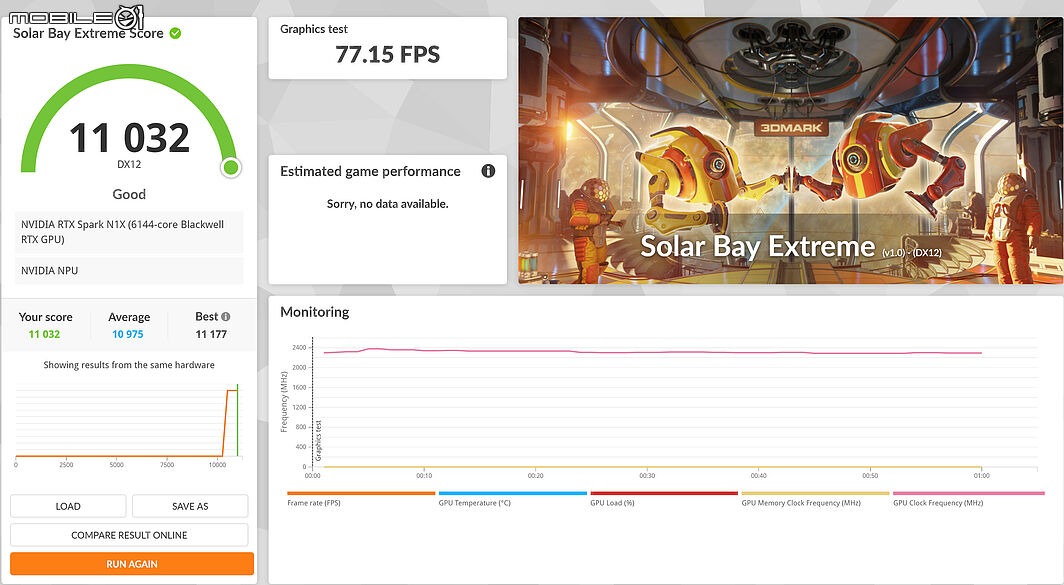
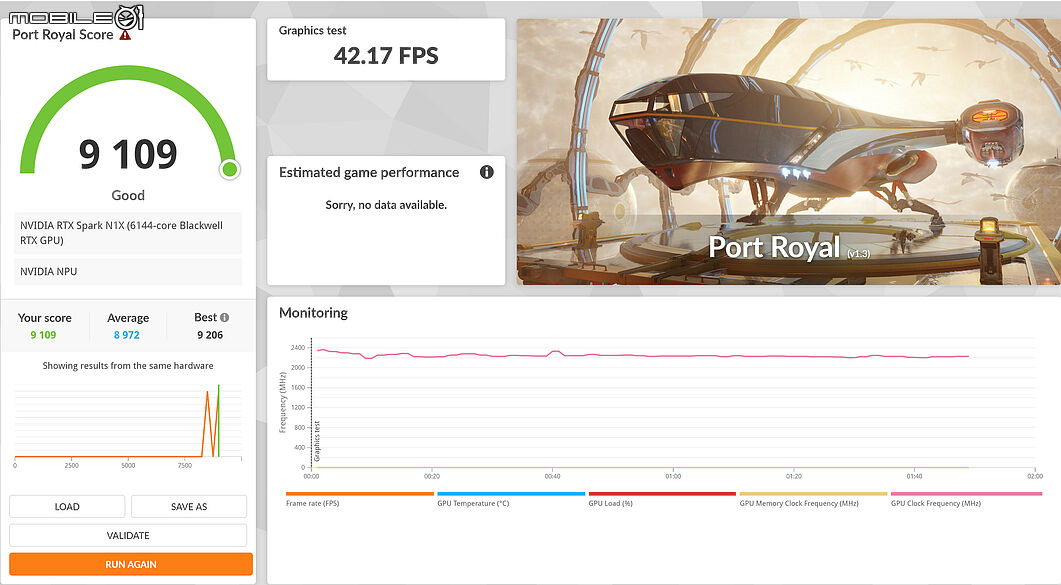
圖形效能測試方面,這次也使用 3DMark 測試軟體中支援 ARM 架構的測試模式進行,首先看到 3DMark Steel Nomad 的測試模型中,獲得 3,198 分的效能表現,而在 3DMark Speed Way 測試模型則測得 3,009 分的效能分數;而在 Port Royal 與 Solar Bay Extreme 的測試模型下,則分別獲得 9,109 分與 11,032 分。而內建的 Blackwell RTX GPU 也支援 NVIDIA DLSS 5、Reflex 2、G-SYNC,以及 CUDA、TensorRT 等技術,因此我也針對 NVIDIA DLSS 的功能來進行測試,在 DLSS 圖形加速技術的開啟前後的效能差異,則有著約 3.3 倍的效能提升。
- Blender 渲染效能
- V-Ray 6 渲染效能
- V-Ray 6 GPU CUDA(CPU)
- V-Ray 6 GPU CUDA(GPU)
- V-Ray 6 GPU RTX
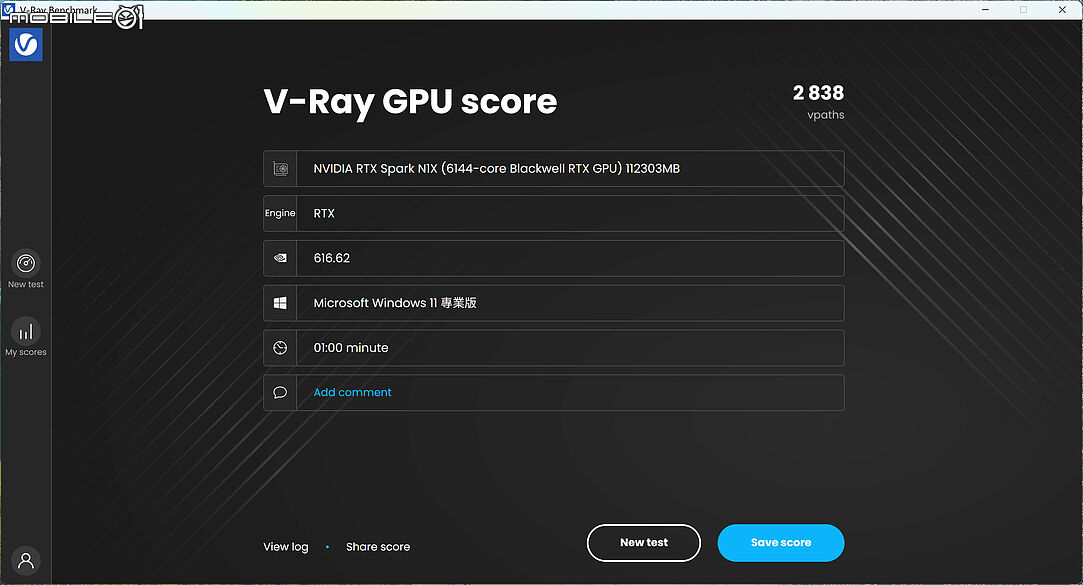
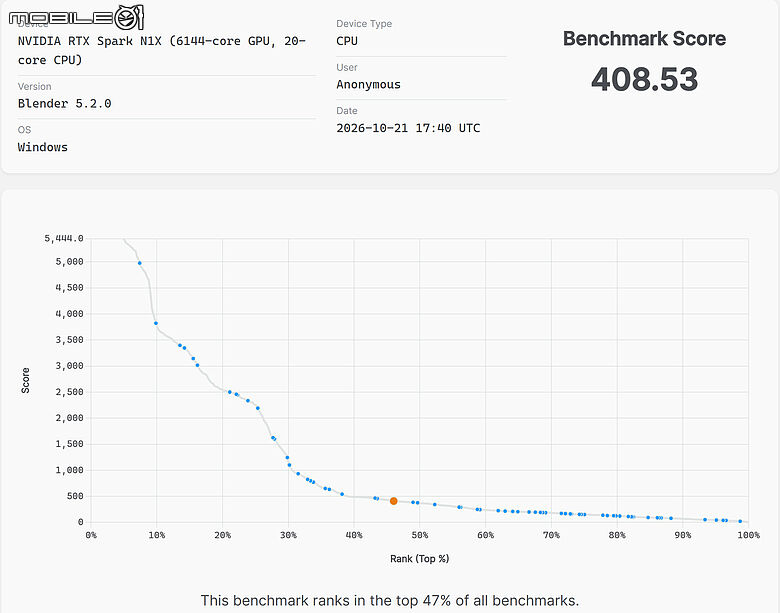
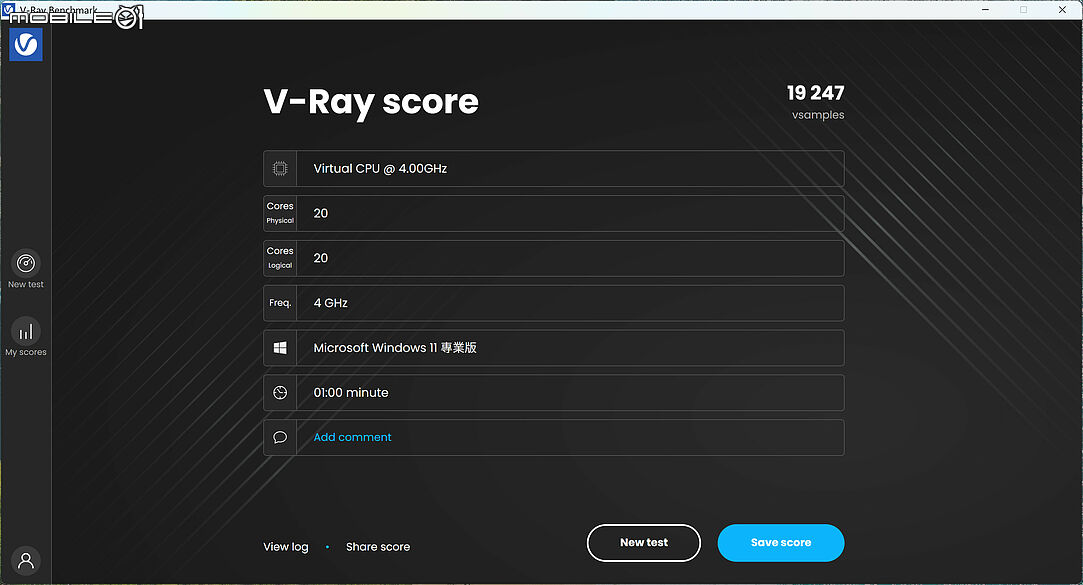
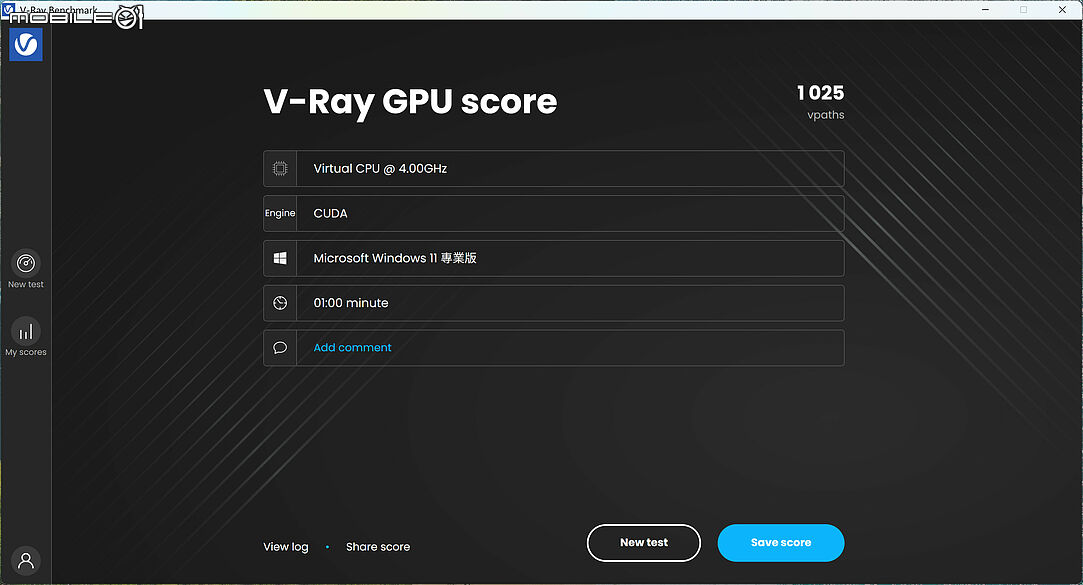
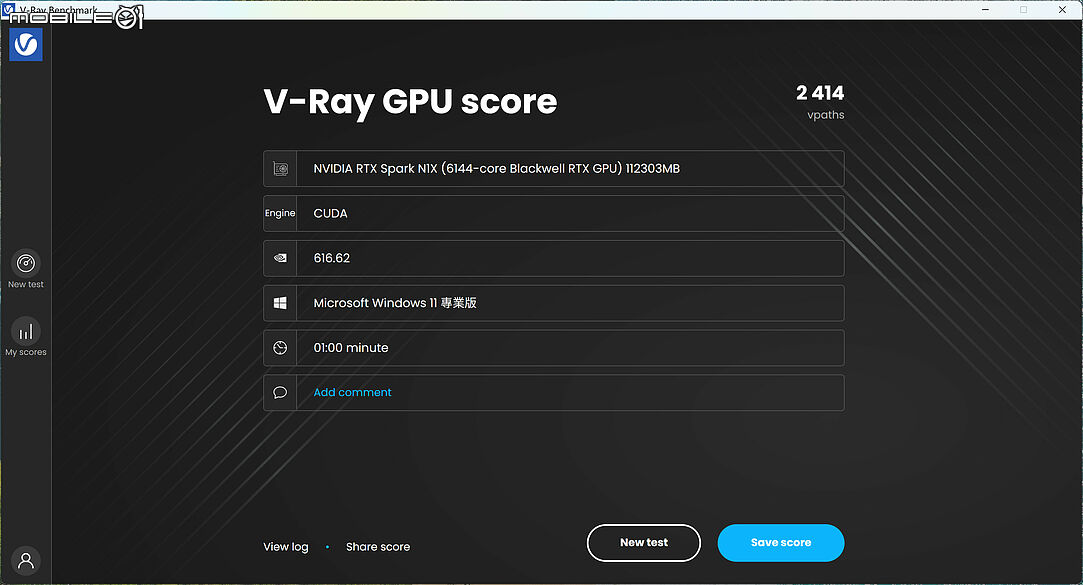
在 3D 動畫創作軟體 Blender 基準效能測試中,在模擬渲染測試獲得 408.53 分,效能排行在受測裝置中落在 47% 的位置,這表示這款筆電除能應付日常多工與內容創作需求之外,也具備執行專業 3D 渲染工作負載的效能使用需求。而在 3D 渲染插件軟體 V-Ray 6 測試軟體中,在 CUDA 渲染模式下獲得 2,414 vpaths,切換至 RTX 渲染模式後,效能表現則進一步提升至 2,838 vpaths 效能表現,整體效能增加約 17.56%。這也代表 N1X 所搭載的 Blackwell RTX GPU 除了能透過 CUDA 核心執行運算外,如搭配 RTX 光線追蹤加速技術的話,也能進一步提升更多 3D 渲染工作負載的處理運算效率。
- AI 圖片生成(SD 1.5)
- AI 圖片生成(SD 1.5 Light)
- AI 圖片生成(SD XL)
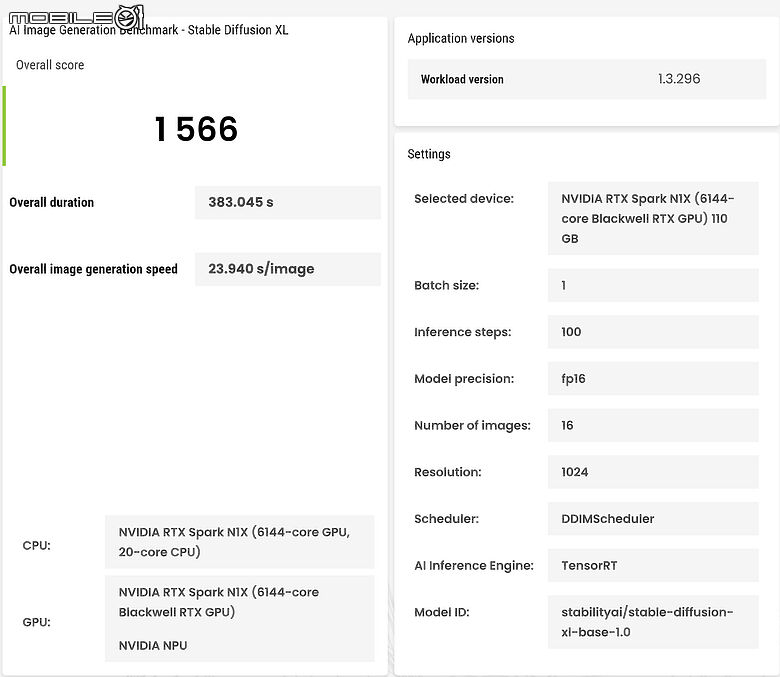
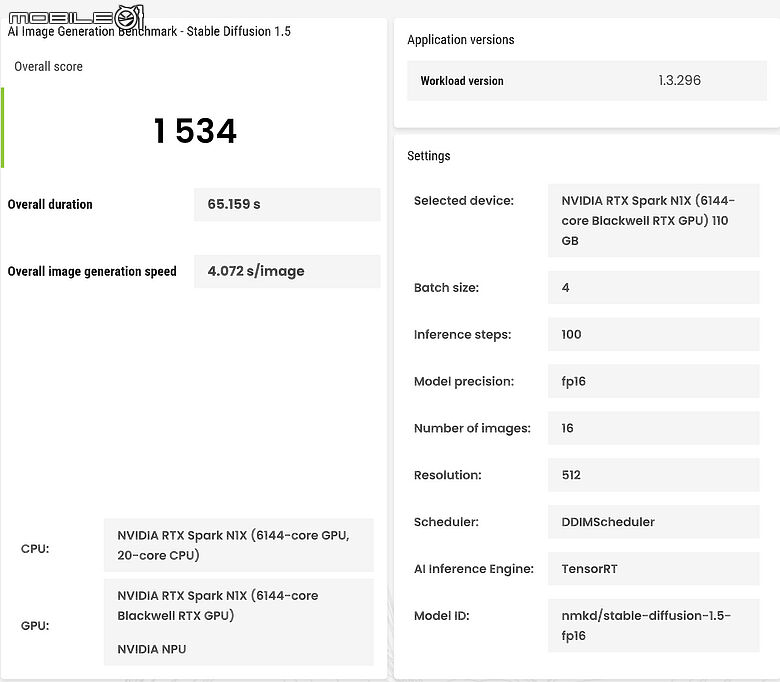
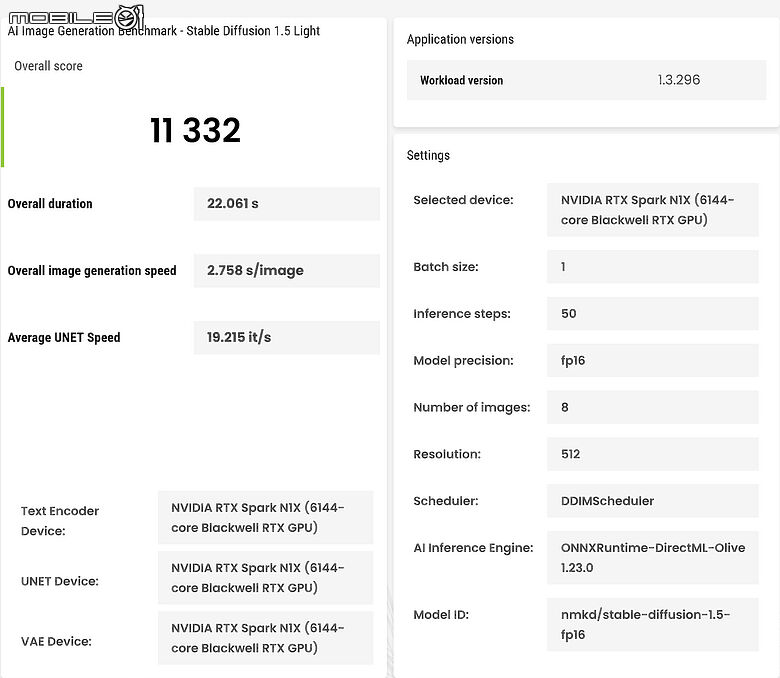
在 AI 圖像生成的效能測試,布萊恩同樣使用 UL Procyon AI Image Generation Benchmark 來進行實測。首先,在標準 Stable Diffusion 1.5 測試環境下,最終獲得效能成績 1,534 分,完成 16 張 512×512 解析度圖片共耗時 65.159 秒,平均每張圖片僅需 4.072 秒;接著,在運算負載較輕的 Stable Diffusion 1.5 Light 測試環境下,獲得實測效能成績為 11,332 分,完成 8 張 512×512 解析度圖片僅耗時 22.061 秒,平均每張圖片生成時間縮短至 2.758 秒。
最後則要來看到運算需求更高的 Stable Diffusion XL 測試環境下,則將圖片解析度提高至 1024×1024,並維持 FP16 精度與 100 個推論步數設定,最終獲得的效能成績則為 1,566 分,完成 16 張圖片總耗時 383.045 秒,平均每張圖片生成時間約為 23.940 秒。透過三種不同的 AI 圖片生成測試環境的測試結果,可以看出 Prestige N16 Flip AI+ 除具備本地端的 AI 圖片生成的高效率輸出外,更擁有能夠快速執行較高運算負載 AI 圖像生成工作的能力。
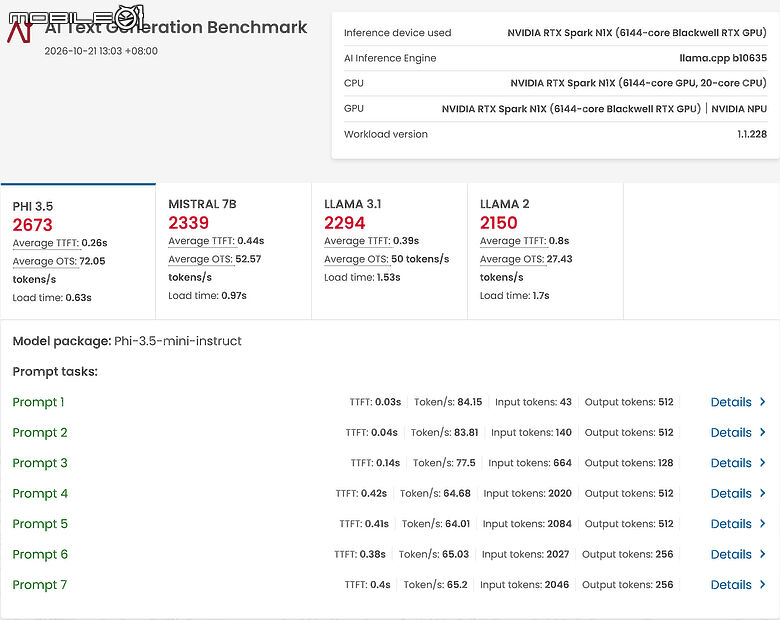
另外布萊恩也進行了 AI 文字生成效能的實際測試,使用 UL Procyon AI Text Generation Benchmark,同時搭配 llama.cpp 推論引擎。從四種不同的推論模型的實測結果來看,Phi 3.5、Mistral 7B、Llama 3.1 與 Llama 2 分別獲得 2,673 分、2,339 分、2,294 分及 2,150 分。
其中,在 Phi 3.5 的平均輸出速度達到 72.05 tokens/s,首次 Token 回應時間僅 0.26 秒,模型載入時間也只有 0.63 秒,至於 Mistral 7B 與 Llama 3.1,平均文字生成速度則分別達到 52.57 tokens/s 與 50 tokens/s,兩者的 AI 文字生成效能表現相當接近。
從實際的測試結果可以看到,這款筆電除了可作為本地端 AI 文字生成與智慧助理的運算平台,也能為大型語言模型部署、文件分析及生成式 AI 應用開發提供完整的效能輸出,同時也具備處理較長文字輸入的實用性效能表現。
- AI Computer Vision 2.0 Benchmark
- AI Computer Vision 2.0 Benchmark
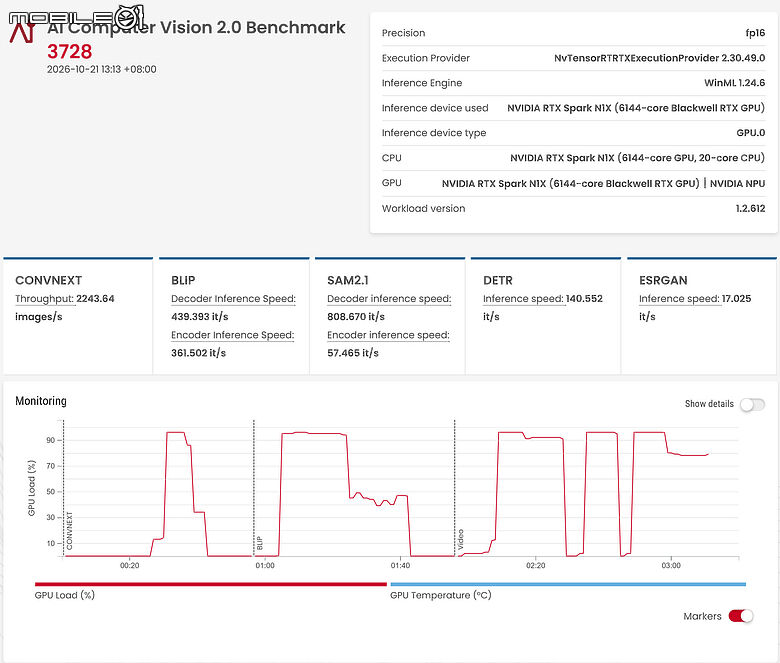
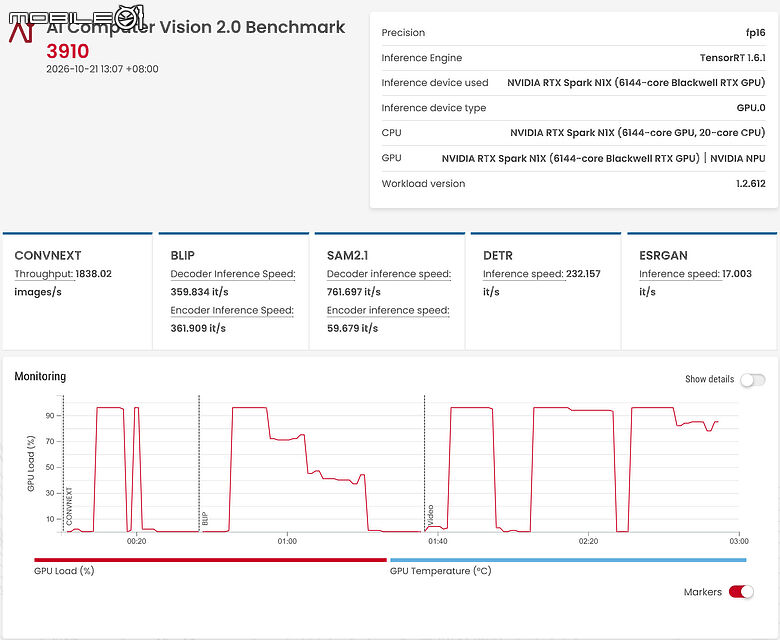
在 AI Computer Vision 2.0 的測試模式中,我也分別使用 TensorRT 1.6.1 與 WinML 1.24.6 兩種推論環境進行這款筆電的實際測試,同時都採用 FP16 半精度運算模式。測試結果分別為 TensorRT 模式獲得 3,910 分的效能分數,而 WinML 則測得 3,728 分的效能分數。其中,在 ConvNeXt 圖像分類測試環境下,WinML 達到每秒 2,243.64 張圖片的處理速度,相較於 TensorRT 的 1,838.02 張處理速度約有 22.1% 的提升;而在 BLIP 圖像理解模型的 Decoder 測試中,WinML 同樣有著約 22.1% 的處理效能提升。從實際的測試結果可以看到,Prestige N16 Flip AI+ 除可用於本地端 AI 圖像生成與大型語言模型推論,也很適合作為 AI 模型測試、應用開發及本地端推論部署的工作平台。
- 《Cyberpunk 2077》遊戲效能
- 《漫威爭鋒》遊戲效能
- 《戰爭機器:E-Day》遊戲效能
- 《極限競速 6》遊戲效能
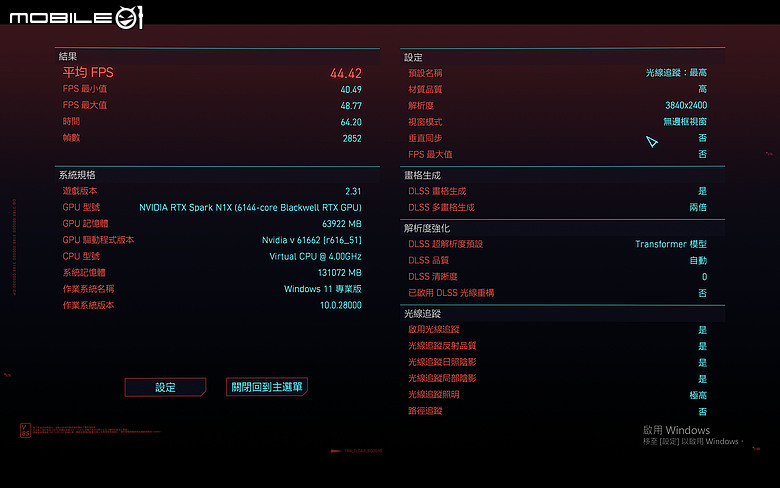
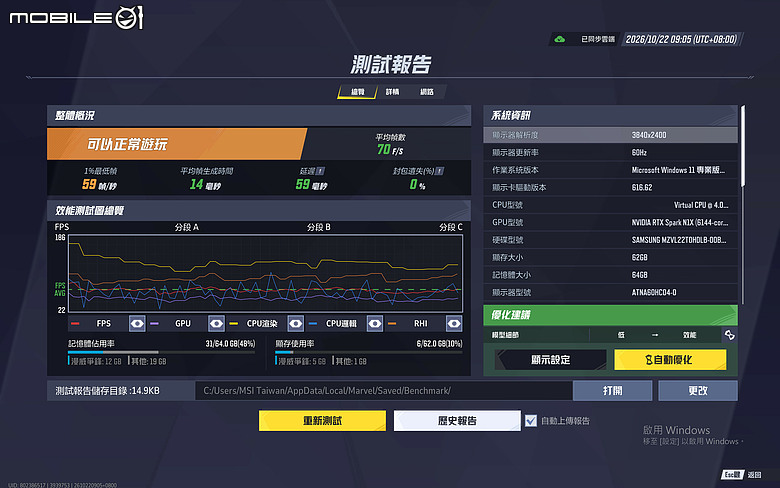
最後在實機遊戲效能測試,我則是選擇了《電馭叛客 2077》、《漫威爭鋒》、《戰爭機器:E-Day》與《極限競速 6》四款 3A 遊戲來進行測試,測試環境均設定為 3840×2400 解析度,並開啟 DLSS 等相關功能,遊戲畫質設定則依照各遊戲的推薦設定進行。首先,在《電馭叛客 2077》,我則是將遊戲畫質設定為光線追蹤最高等級,並開啟 DLSS 超解析度與 2 倍多畫格生成技術,最終測得平均 44.42 FPS 的效能表現;接著,在《漫威爭鋒》的遊戲測試中,則獲得平均 70 FPS 的遊戲效能表現。
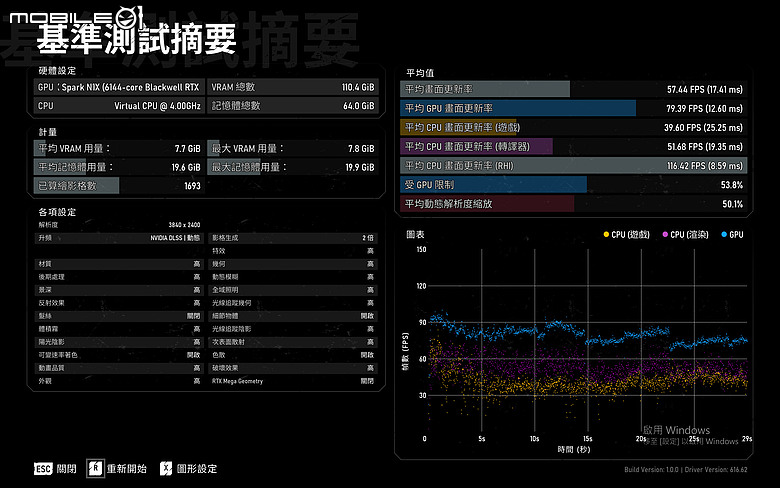
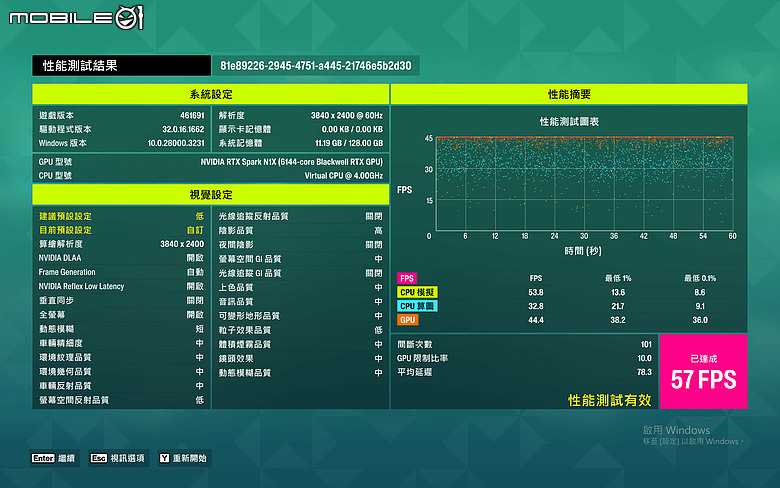
接著是《戰爭機器:E-Day》則是在高畫質設定下,搭配 DLSS 動態升頻與 2 倍影格生成技術,最終測得平均 57.44 FPS 的效能表現。最後在《極限競速 6》的遊戲中,我則是開啟 NVIDIA DLAA 與 Reflex Low Latency 功能,則是測得平均 57 FPS 的效能表現成績。從上方的四款 3A 遊戲實測結果,不難發現 RTX Spark N1X 所搭載的 Blackwell RTX GPU,確實具備執行高解析度 3A 遊戲的能力,同時在 DLSS 超解析度與影格生成技術的加持下,即便是高負載的遊戲,也能獲得不錯的效能表現。不過,如果希望在超高解析度的遊戲環境下,維持更穩定的 60 FPS 以上的效能表現,還是建議各位要降低部分遊戲畫質設定,才能在視覺效果與遊戲流暢度之間取得更好的平衡。
整體來說,本次實際測試的 MSI Prestige N16 Flip AI+ RTX Spark 筆電,MSI 不僅延續了 Prestige 系列原有的高階商務與創作定位,更藉由導入 NVIDIA RTX Spark N1X 超級晶片,透過 20 核心 Grace CPU、6,144 個 CUDA 核心的 Blackwell RTX GPU,加上 128GB LPDDR5X 統一記憶體的高階規格配置,也讓這款筆電在維持相同的重量與厚度結構下,能夠高效率的應付一般多工處理、專業內容創作與本地端 AI 運算的使用情境上。
此外,Prestige N16 Flip AI+ 也延續了 16 吋 UHD+ Tandem OLED 螢幕、120Hz 更新率、360 度翻轉機身,以及 MSI Nano Pen 觸控筆的操作,使其依然是一款能夠滿足日常工作、簡報展示與內容創作的高階效能筆電。不過,如果真的有心(也有錢)想要入手這款筆電的朋友,即便目前 Windows on ARM 已經能支援不少常見應用程式,但如果平常需要使用特定的專業軟體、外接設備或開發工具,在入手前還是強烈建議先確認是否具備原生支援或能正常運作。此外,RTX Spark N1X 雖然擁有出色的 AI 與圖形運算能力,且在插電與未連接電源時的效能表現沒有太明顯的差距,但還是建議如有大量 AI 推論或渲染需求的朋友們,還是盡量在連接電源的環境下使用。
最後,透過這次的實際測試,也可證明如果想要入手 RTX Spark 筆電的話,還是建議直接購入具備 128GB 統一記憶體的最高階版本,這樣能夠明顯的感受到在 AI 運算、遊戲體驗與多工處理的應用上,會有更明顯的效能提升,不過前提還是要在預算許可的情況下,再來考慮最高階的版本入手。
▊福利社
 登入回文還可以看到福利社資訊